Bulk Insert 적용으로 대용량 입력 성능 개선하기
1. 개요
이전 포스트에서 본 것과 같이 수많은 row 를 가진 파일이 입력되는 경우,
해당 row 개수 만큼 INSERT 문이 실행되어 입력에 시간이 매우 오래 걸리는 상황이 발생했다.
이를 해결하기 위해 노력한 과정을 공유하고자 한다.
이를 해결하기 위해 노력한 과정을 공유하고자 한다.
2. 현재 상황 살펴보기
java
List<DuplicatedGroup> newGroupsToSave = itemsToSave.stream()
    .map(Item::getDuplicatedGroup)
    .filter(group -> group != null && group.getId() == null)
    .distinct()
    .toList();

if (!newGroupsToSave.isEmpty()) {
    duplicatedGroupRepository.saveAll(newGroupsToSave);
}

if (!existingItemsToUpdate.isEmpty()) {
    itemRepository.saveAll(existingItemsToUpdate);
}

// ← 이 부분!
List<Item> savedItems = itemRepository.saveAll(itemsToSave);

if (!issues.isEmpty()) {
    issueRepository.saveAll(issues);
}

return savedItems;
saveAll() 은 한번에 저장하는 것처럼 보이지만,
사실 리스트 내의 값을 하나씩 읽어와서 각각 INSERT 한다.
또한 해당 리스트 내부의 값은 아래 과정을 거치고 저장된다.
[파싱] → [컬렉션 메모리에 임시 저장] → [이상 탐지] → [DB insert]
10만 개와 같은 대용량 데이터에 대해 위 과정을 모두 적용한다면 적지 않은 메모리 사용과 시간이 소요될 것이다.
3. saveAll() 개선하기
부분부분 개선이 가능한 부분부터 접근한다. saveAll() 은 리스트 내부의 모든 요소에 대해 INSERT 문을 실행하기 때문에 이를 수정해서 성능을 개선해보고자 한다.
⚡ Bulk Insert
개념
여러 행을 한 번의 INSERT 문으로 삽입
장점
트랜잭션 수 감소, 리소스 사용 최적화
단점
트랜잭션이 매우 커짐. 오류 발생 시 전체 삽입 실패 가능
🗂️ LOAD DATA INFILE
개념
외부 CSV 파일을 MySQL 테이블에 직접 로드
장점
Bulk Insert 보다 빠름. 앱 메모리 거의 미사용 (OOM 없음)
단점
트랜잭션 관리 어려움. 비즈니스 로직 적용 불가. 파일 형식 종속
🤔
의사 결정
현재 프로젝트에서는 들어오는 데이터에 대해 비즈니스 로직을 수행함과 동시에 입력 시간 단축 및 메모리 절약도 필요하기 때문에 Bulk Insert 를 적용해보기로 했다.
현재 프로젝트에서는 들어오는 데이터에 대해 비즈니스 로직을 수행함과 동시에 입력 시간 단축 및 메모리 절약도 필요하기 때문에 Bulk Insert 를 적용해보기로 했다.
💭
추가 고려 사항
CSV 파일의 경우는 LOAD DATA INFILE 로 미리 데이터를 받고, 받은 데이터를 기반으로 비즈니스 로직을 수행하는 것도 고려해봤다.
수행 시 CSV 입력은 별도 서비스 코드로 분리될 것으로 예상된다. 다른 branch 작업 예정
CSV 파일의 경우는 LOAD DATA INFILE 로 미리 데이터를 받고, 받은 데이터를 기반으로 비즈니스 로직을 수행하는 것도 고려해봤다.
수행 시 CSV 입력은 별도 서비스 코드로 분리될 것으로 예상된다. 다른 branch 작업 예정
4. Bulk Insert 적용해보기
- 테이블 간 여러 관계가 존재하기 때문에 이 또한 함께 고려해야 한다.
- JDBC 와 JPA 를 같이 쓰게 되면 영속성 관리에 더 신경을 써야 한다.
- Item 의 자식 테이블인 Issue 역시 JDBC 를 사용해야 정상 적용이 된다.
💾 ItemBulkRepository.java
JDBC batchUpdate — Item 벌크 입력
java
@Repository
@RequiredArgsConstructor
public class ItemBulkRepository {
    private final JdbcTemplate jdbcTemplate;

    @Transactional
    public void saveAllItemsInBatch(List<Item> items, int batchSize) {

        String sql =
            "INSERT INTO `items` (\n"
            + "  `effective_date`, `duplicated_group_id`, `file_id`, `price_after`, `price_before`,\n"
            + "  `row_no`, `doc_id`, `normalized_item_name`, `raw_item_name`, `spec`,\n"
            + "  `supplier_name`, `unit`, `review_status`, `source_type`, `created_at`\n"
            + ") VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, NOW())";

        jdbcTemplate.batchUpdate(sql, items, batchSize,
            (PreparedStatement ps, Item item) -> {
                ps.setObject(1, item.getEffectiveDate()); // LocalDate → setObject

                if (item.getDuplicatedGroup() != null)
                    ps.setLong(2, item.getDuplicatedGroup().getId());
                else
                    ps.setNull(2, java.sql.Types.BIGINT);

                if (item.getFile() != null)
                    ps.setLong(3, item.getFile().getId());
                else
                    ps.setNull(3, java.sql.Types.BIGINT);

                ps.setLong(4,  item.getPriceAfter());
                ps.setLong(5,  item.getPriceBefore());
                ps.setLong(6,  item.getRowNo());
                ps.setString(7,  item.getDocId());
                ps.setString(8,  item.getNormalizedItemName());
                ps.setString(9,  item.getRawItemName());
                ps.setString(10, item.getSpec());
                ps.setString(11, item.getSupplierName());
                ps.setString(12, item.getUnit());
                ps.setString(13, item.getReviewStatus() != null
                    ? item.getReviewStatus().name() : null);  // Enum → setString
                ps.setString(14, item.getSourceType() != null
                    ? item.getSourceType().name() : null);
            }
        );
    }
}
LocalDate타입은setObject로, Enum 타입은setString으로 설정이 가능하다.
created_at을 직접 설정한 이유는, JDBC 로 입력하는 단계에서는 JPA 영속성 컨텍스트에 포함되지 않기 때문이다.
⚠️
Issue 도 함께 JDBC Bulk Insert 를 적용해야 한다.
Item 을 JDBC 로 입력하면 JPA 영속성 컨텍스트의 관리를 받지 않기 때문에, 영속성 전이 (Cascade) 나 자동 FK 매핑을 사용할 수 없다.
따라서 자식 객체인 Issue 또한 동일하게 JDBC Bulk Insert 방식으로 직접 부모 ID 를 참조시켜 저장해야 한다.
Item 을 JDBC 로 입력하면 JPA 영속성 컨텍스트의 관리를 받지 않기 때문에, 영속성 전이 (Cascade) 나 자동 FK 매핑을 사용할 수 없다.
따라서 자식 객체인 Issue 또한 동일하게 JDBC Bulk Insert 방식으로 직접 부모 ID 를 참조시켜 저장해야 한다.
5. 성능 테스트
5-1. 응답 시간 테스트
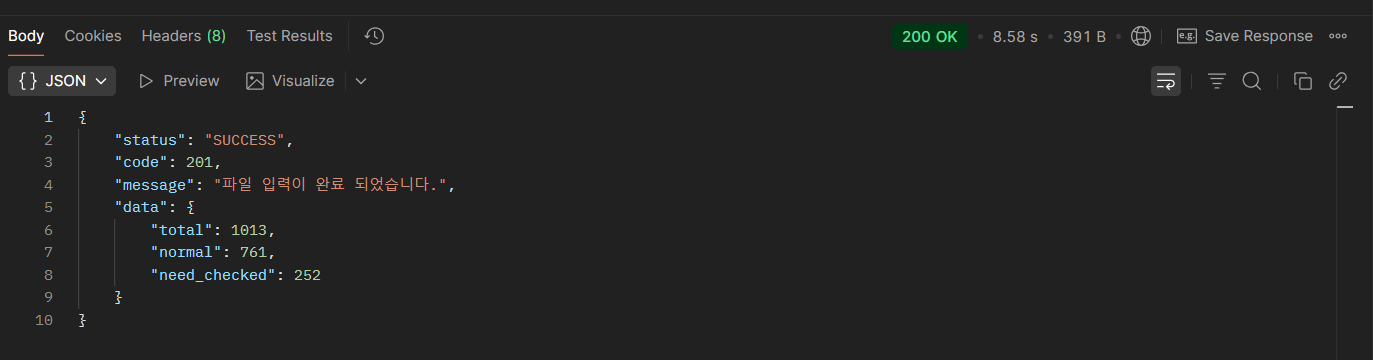
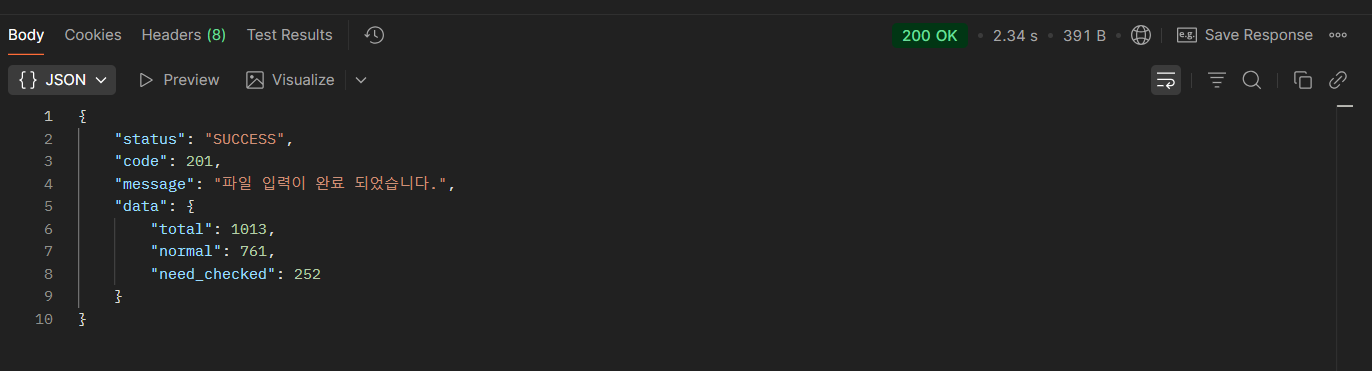
1,000 row 파일 입력
Before (JPA saveAll)
8 s
1,000 row 신규 입력
After (Bulk Insert, batch=1000)
2 s
동일 파일 — 400% 속도 개선
Before
After
🚨
트러블 슈팅 : 동일 데이터를 한 번 더 넣으면 서버 에러 발생
java
if (!existingItemsToUpdate.isEmpty()) {
    itemBulkRepository.saveAllInBatch(existingItemsToUpdate); // ← 문제 지점
}
existingItemsToUpdate 는 원래 JPA 변경 감지(Dirty Checking) 로 UPDATE 되어야 하는 항목인데,
saveAllInBatch 는 INSERT 를 실행하기 때문에 기존 데이터를 또 생성하려다 에러가 발생한 것이다.
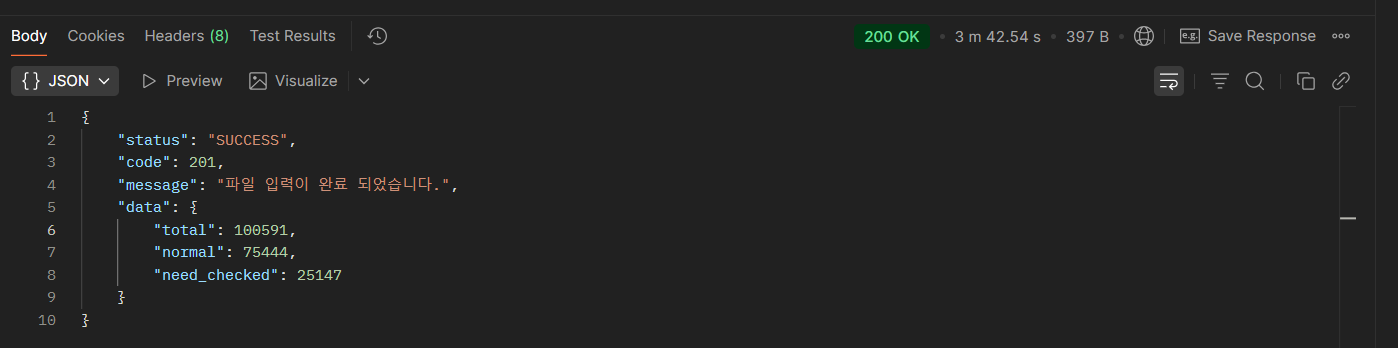
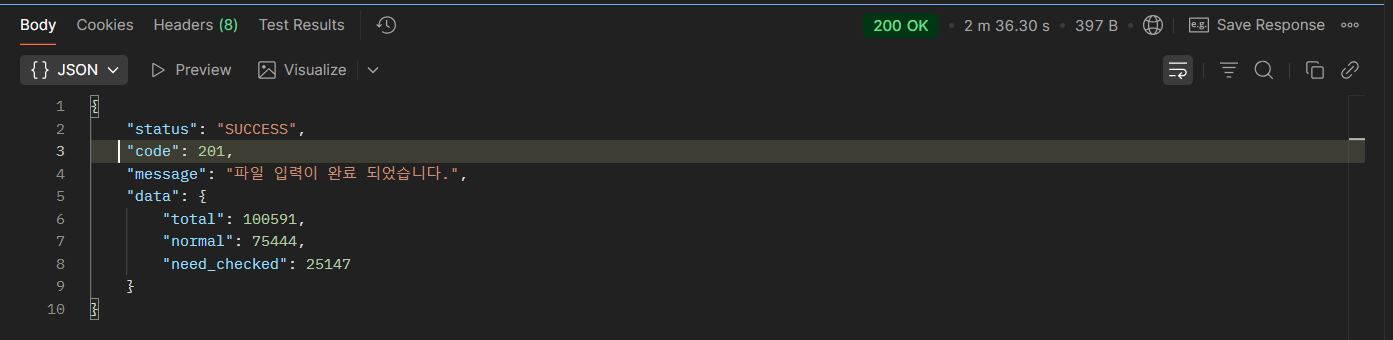
10만 row 파일 입력
| 조건 | 소요 시간 | 비고 |
|---|---|---|
| Before (JPA saveAll) | 1시간 이상 | 측정 불가 |
| After (batch = 1,000) | 약 3 분 | 결과 확인 가능 수준 |
| After (batch = 5,000) | 약 2 분 | 1분 단축 — 단, 메모리 부하 및 롤백 어려움 증가 |
batch = 1,000
batch = 5,000
💡
정상적인 JDBC 설정이면 10만 건은 약 5초 내에 완료되어야 한다고 한다.
현재 시간이 오래 걸리는 원인은 각 row 에 대한 중복 검사 로직 때문이며, 이 또한 개선해야 할 사항이다.
현재 시간이 오래 걸리는 원인은 각 row 에 대한 중복 검사 로직 때문이며, 이 또한 개선해야 할 사항이다.
5-2. 메모리 측정 (VisualVM)
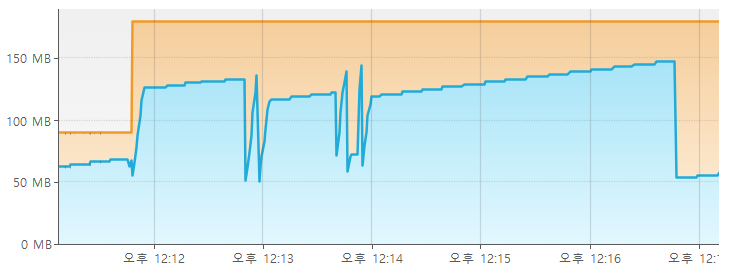
1,000 row 샘플 (Batch Size 5,000)
Before
최대 150 MB
Heap 점유
After
최대 125 MB
Heap 점유
Before
After
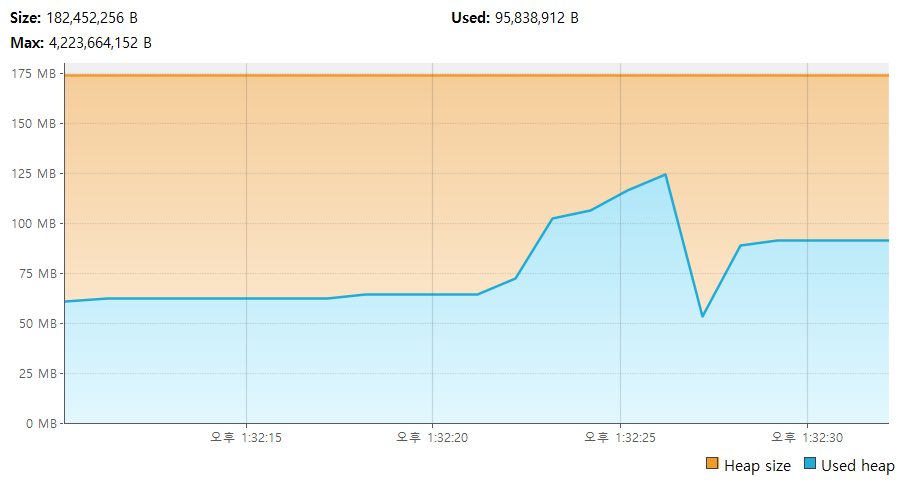
최대 Heap 점유 용량과 점유 시간 모두 확실히 유의미한 개선 효과가 보인다.
Batch Size 가 크면 메모리도 많이 점유하기 때문에 적절한 조절이 필요하다.
10만 row 샘플 (Batch Size 5,000)
Before (측정 중단)
최대 650 MB
Heap 점유
After
최대 350 MB
Heap 점유 — 약 46% 감소
Before
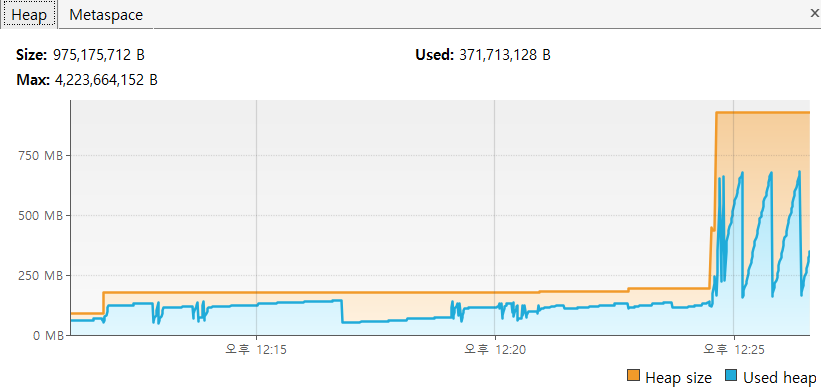
After

메모리 점유 사용률이 약 46% 감소했다.
특정 구간에서 사용량이 올라간 것은 중복 탐지 로직의 Java Collection 사용으로 인한 현상으로 보인다.
🙂
이렇게 메모리 테스트도 진행해 보았다.
비록 현업에서는 더 고도화되고 체계적으로 테스트하겠지만, 성능 측정에 있어서도 더 배우고 개선해 나가는 개발자로 성장하고 싶다.
비록 현업에서는 더 고도화되고 체계적으로 테스트하겠지만, 성능 측정에 있어서도 더 배우고 개선해 나가는 개발자로 성장하고 싶다.
NEXT TO DO
-
중복 검사 로직이 병목 원인임을 확인했으므로, 다음 포스트에서 이를 개선할 예정이다.
-
Bulk Insert 를 처음 적용해보았지만 아직 부족한 점이 많아 추가 학습이 필요하다.
-
대용량 처리 프레임워크인 Spark, Hadoop, Kafka 와 같은 기술도 공부해보면 좋을 것 같다.
-
JPA 와 JDBC 를 함께 쓸 때 영속성 관리 측면에서 신경 써야 할 점이 많다는 것을 느꼈고, 관련 학습이 필요하다.
'프로젝트 > 보살핌 프로젝트' 카테고리의 다른 글
| 3. 중복 탐지 로직 최적화 (1) (0) | 2026.09.03 |
|---|---|
| 1. 이상 탐지 리팩토링 (0) | 2026.08.27 |
| 0. 해커톤 개요 (0) | 2026.08.25 |