중복 탐지 구조 개선 & CSV 파싱 성능 최적화
SRP 기반 메서드 분리 · readAll() → readNext() · 5분 → 40초 · Spring Boot

0. 개요

메모리 상에서 이루어지고 있는 중복 탐지 로직을 DB 관점에서 성능 개선해보려고 한다.

이 포스트에서는 현재 입력되는 DTO 간의 중복 탐지 로직의 코드를 개선하고, 10만 건 입력 시 응답 시간이 오래 걸리는 원인을 발견한 후 이를 해결해 나가고자 한다.

1. 현재 코드 살펴보기

ItemService.java — createCommonItem
java
// 아이템 이상 탐지 및 저장 서비스 메서드
public List<Item> createCommonItem(List<CreateCommonItemDocumentReqDto> reqDtos, File savedFile) {

    // 1. 검증 및 중복 매핑 결과 취득
    DuplicateValidationResult validationResult =
        itemDocumentDuplicateValidator.markDuplicatesForCommon(
            reqDtos, itemRepository.findAllByDeletedAtIsNullOrderByIdAsc()
        );

    List<Item> existingItemsToUpdate = new ArrayList<>();
    List<Boolean> isDuplicateFlags = new ArrayList<>();

    // 2. DTO -> Item 엔티티 및 DuplicatedGroup 연관관계 구성
    List<Item> itemsToSave = processItemsAndGroups(
        reqDtos, validationResult, savedFile, existingItemsToUpdate, isDuplicateFlags
    );

    // 3. 기타 이상 탐지 및 이슈(Issue) 수집
    List<Issue> issues = detectIssues(itemsToSave, reqDtos, isDuplicateFlags);

    // 4. 데이터 일괄 저장
    return saveAllEntities(itemsToSave, existingItemsToUpdate, issues);
}
ItemDocumentDuplicateValidator 에서 중복 row 를 탐지하고, 해당 정보를 DuplicateValidationResult 에 담아서 전달하고 있는 모습이다.
ItemDocumentDuplicateValidator.java — markDuplicatesForCommon (기존)
java
public DuplicateValidationResult markDuplicatesForCommon(
    List<CreateCommonItemDocumentReqDto> dtos, List<Item> allExistingItems
) {
    if (dtos.isEmpty()) {
        return new DuplicateValidationResult(Map.of(), List.of());
    }

    // DB 기존 데이터 Key -> Item 매핑
    Map<String, Item> existingDbMap = new HashMap<>();
    for (Item item : allExistingItems) {
        String key = generateKey(...);
        existingDbMap.putIfAbsent(key, item);
    }

    // 현재 입력 데이터 처리 (DB 체크 + 자가 중복 체크가 혼재)
    Map<String, CreateCommonItemDocumentReqDto> firstSeenMap = new HashMap<>();
    for (CreateCommonItemDocumentReqDto dto : dtos) {
        String normalizedName = itemNameMapper.map(dto.getRawItemName());
        dto.setNormalizedItemName(normalizedName);

        String key = generateKey(...); // 모든 DTO에 대해 Key 생성

        if (existingDbMap.containsKey(key) || firstSeenMap.containsKey(key)) {
            dto.setDuplicateGroupKey(key);
            if (firstSeenMap.containsKey(key) && firstSeenMap.get(key).getDuplicateGroupKey() == null) {
                firstSeenMap.get(key).setDuplicateGroupKey(key);
            }
        } else {
            firstSeenMap.put(key, dto);
        }
    }

    return new DuplicateValidationResult(existingDbMap, dtos);
}
⚠️
문제점
  • 하나의 메서드에서 "DTO 간 자가 중복 체크" 와 "DB 데이터 포함 중복 체크" 를 함께 진행하고 있어 역할이 혼재되어 있다.
  • 모든 DTO 에 대해 generateKey() 를 실행하고 있기 때문에, 중복이 의심되는 경우에만 Key 를 생성하도록 수정이 필요하다.

2. 구조화 해보기

기존의 markDuplicatesForCommon 메서드에서 DTO 체크와 DB 체크가 얽혀 있던 것을 역할에 따라 메서드로 분리한다.

① 정규화
→
② 파일 내 자가 중복 탐지
→
③ DB 포함 중복 탐지
🔀 markDuplicatesForCommon 리팩토링 후 — 3단계 위임 구조
java
public DuplicateValidationResult markDuplicatesForCommon(
    List<CreateCommonItemDocumentReqDto> dtos, List<Item> allExistingItems
) {
    if (dtos.isEmpty()) {
        return new DuplicateValidationResult(Map.of(), List.of());
    }

    // 1. DTO 품목명 정규화 (선행 조건)
    normalizeItemNames(dtos);

    // 2. 파일 내부 (DTO 간) 중복 탐지 및 GroupKey 부여
    markFileSelfDuplicates(dtos);

    // 3. DB 기존 데이터와의 중복 탐지
    Map<String, Item> existingDbMap = markDbDuplicates(dtos, allExistingItems);

    return new DuplicateValidationResult(existingDbMap, dtos);
}
📝 normalizeItemNames 품목명 정규화
java
private void normalizeItemNames(List<CreateCommonItemDocumentReqDto> dtos) {
    for (CreateCommonItemDocumentReqDto dto : dtos) {
        String normalizedName = itemNameMapper.map(dto.getRawItemName());
        dto.setNormalizedItemName(normalizedName);
    }
}
🔁 markFileSelfDuplicates 파일 내부 DTO 간 중복 탐지 — Key 생성 최소화
java
private void markFileSelfDuplicates(List<CreateCommonItemDocumentReqDto> dtos) {

    // String Key 대신 DTO 자체를 Key로 사용 → generateKey() 호출 최소화
    Map<CreateCommonItemDocumentReqDto, CreateCommonItemDocumentReqDto> firstSeenMap =
        new HashMap<>(135_000);

    for (CreateCommonItemDocumentReqDto dto : dtos) {
        CreateCommonItemDocumentReqDto firstSeenDto = firstSeenMap.get(dto);

        if (firstSeenDto == null) {
            // 최초 등장 → Map 에 등록
            firstSeenMap.put(dto, dto);
        } else {
            // 중복 발견 → 필요 시점에만 String Key를 1회 생성하여 공유
            if (firstSeenDto.getDuplicateGroupKey() == null) {
                String groupKey = generateKeyFromDto(firstSeenDto);
                firstSeenDto.setDuplicateGroupKey(groupKey);
            }
            dto.setDuplicateGroupKey(firstSeenDto.getDuplicateGroupKey());
        }
    }
}
🗄️ markDbDuplicates DB 기존 데이터 매핑 + DB와의 중복 탐지
java
private Map<String, Item> markDbDuplicates(
    List<CreateCommonItemDocumentReqDto> dtos, List<Item> allExistingItems
) {
    if (allExistingItems == null || allExistingItems.isEmpty()) return Map.of();

    Map<String, Item> existingDbMap = new HashMap<>(allExistingItems.size());
    for (Item item : allExistingItems) {
        existingDbMap.putIfAbsent(generateKeyFromItem(item), item);
    }

    for (CreateCommonItemDocumentReqDto dto : dtos) {
        // 자가 중복 Key 가 이미 있으면 재활용, 없으면 신규 생성
        String dtoKey = (dto.getDuplicateGroupKey() != null)
            ? dto.getDuplicateGroupKey()
            : generateKeyFromDto(dto);

        if (existingDbMap.containsKey(dtoKey)) {
            dto.setDuplicateGroupKey(dtoKey);
        }
    }

    return existingDbMap;
}
✅
개선 포인트
  • DTO 체크 / DB 체크를 메서드별로 분리하여 SRP (단일 책임 원칙) 준수
  • 기존 String Key 기반 Map → DTO 객체 자체를 Key로 사용하여 generateKey() 호출을 중복이 감지된 시점에만 실행

3. 소요 시간 측정

시간 소요가 많은 부분을 파악하기 위해 System.nanoTime() 을 이용하여 단계별로 측정하였다.

3-1. 중복 탐지 소요 시간 (10만 건 · DB 데이터 없는 경우)

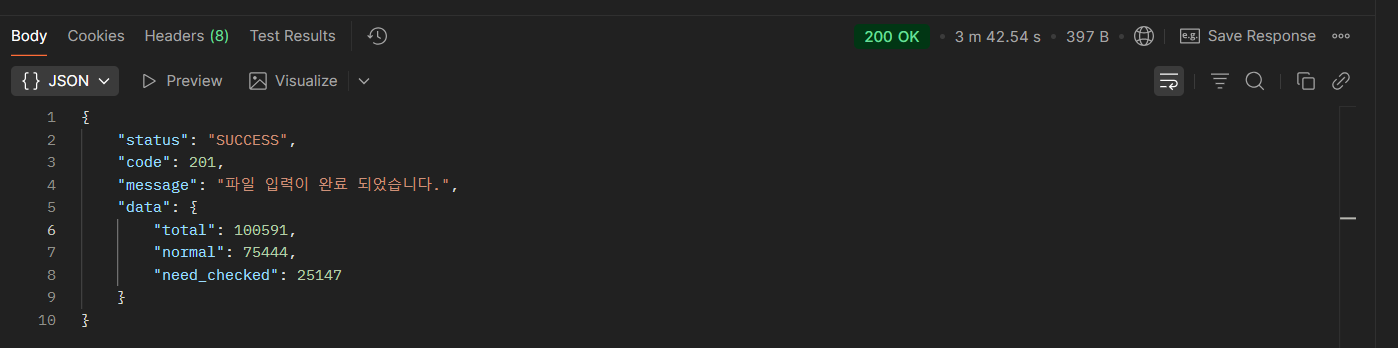
전체 응답 — 약 6분 소요
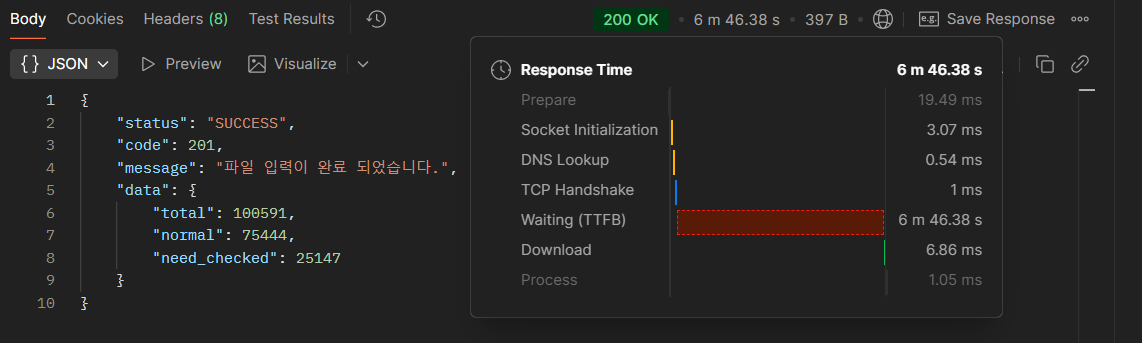


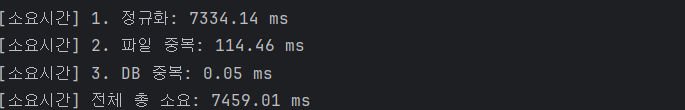
단계별 측정 결과


😮
결과를 보고 놀라지 않을 수 없었다.
당연히 중복 탐지 때문에 오래 걸렸을 것이라 생각했는데, 파싱 + 정규화 + 중복 탐지는 약 7초에 불과했다! (정규화 프로세스가 가장 많이 소요)

따라서 다른 부분의 소요 시간도 측정해보기로 했다.

3-2. 서비스 단 소요 시간 측정

1,000 건

[서비스] 1. 검증 및 매핑: 528.59 ms
[서비스] 2. 연관 관계 구성: 487.06 ms
[서비스] 3. 이상 탐지 및 이슈 수집: 112.38 ms
[서비스] 4. DB 커밋: 396.85 ms
[서비스] 5. 총 시간: 1526.00 ms

[파일서비스] 0-1. 파서 추출: 1.00 ms
[파일서비스] 0-2. file DB 입력: 466.84 ms
[파일서비스] 0-3. 파싱 수행: 130.75 ms
[파일서비스] 0-4. itemService 수행: 1530.46 ms

10만 건

[서비스] 1. 검증 및 매핑: 2949.00 ms
[서비스] 2. 연관 관계 구성: 3436.36 ms
[서비스] 3. 이상 탐지 및 이슈 수집: 3226.39 ms
[서비스] 4. DB 커밋: 16982.73 ms
[서비스] 5. 총 시간: 26595.20 ms

[파일서비스] 0-1. 파서 추출: 9.16 ms
[파일서비스] 0-2. file DB 입력: 610.82 ms
[파일서비스] 0-3. 파싱 수행: 285410.31 ms ← 병목!
[파일서비스] 0-4. itemService 수행: 26599.11 ms

파싱 시간이 전체의 대부분을 차지한다는 것을 확인했다. 소요 시간이 큰 순서대로 성능 개선을 진행한다.


4. 파싱 시간 개선하기

🚨
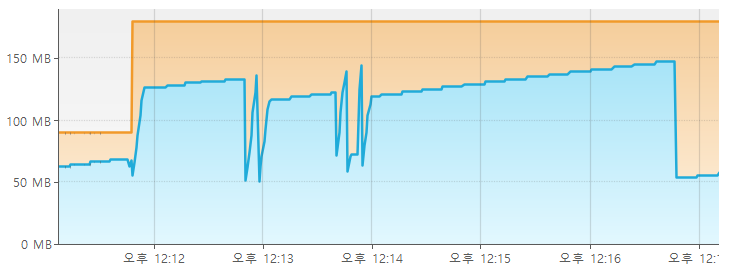
문제 원인 — csvReader.readAll() 로 인한 메모리 폭증
  • List<String[]> rows = csvReader.readAll(); 로 전체 파일을 한번에 메모리에 올려 사용량이 급증한다.
  • Full GC 가 수초간 발생하여 CPU 점유도 높아진다.
  • 메모리 생성 최소화가 필요하다.
Before
readAll()
전체 파일을 List<String[]> 에 한번에 적재
After
readNext()
한 줄씩 읽어 메모리 과부하 방지
📄 CsvParser.java — Before readAll() 방식
java
List<String[]> rows = csvReader.readAll(); // ← 전체를 한번에 메모리에 적재
if (rows.isEmpty()) return list;

for (int i = 1; i < rows.size(); i++) {
    String[] row = rows.get(i);
    // ... DTO 생성
    list.add(dto);
}
📄 CsvParser.java — After readNext() 방식 — 한 줄씩 스트리밍
java
List<CreateCommonItemDocumentReqDto> list = new ArrayList<>(135_000);

String[] row;
long rowNo = 0;

csvReader.readNext(); // 헤더 스킵

// readAll() 대신 한 줄씩 읽기
while ((row = csvReader.readNext()) != null) {
    rowNo++;
    ParseCsvValueHelper.ParseContext context = new ParseCsvValueHelper.ParseContext();

    CreateCommonItemDocumentReqDto dto = CreateCommonItemDocumentReqDto.builder()
        .rowNo(rowNo)
        .docId(ParseCsvValueHelper.parseString(getValue(row, 0)))
        .sourceType(ParseCsvValueHelper.parseString(getValue(row, 1)))
        .supplierName(ParseCsvValueHelper.parseString(getValue(row, 2)))
        .rawItemName(ParseCsvValueHelper.parseString(getValue(row, 3)))
        .spec(ParseCsvValueHelper.parseString(getValue(row, 4)))
        .unit(ParseCsvValueHelper.parseString(getValue(row, 5)))
        .priceBefore(ParseCsvValueHelper.parseLong(getValue(row, 6), context))
        .priceAfter(ParseCsvValueHelper.parseLong(getValue(row, 7), context))
        .effectiveDate(ParseCsvValueHelper.parseDate(getValue(row, 8), context))
        .hasParseError(context.hasError())
        .build();

    list.add(dto);
}

개선 성능 측정 결과

[파일서비스] 0-3. 파싱 수행: 2376.37 ms ← 기존 285,410ms → 약 120배 개선
[서비스] 5. 총 시간: 33170.79 ms
[파일서비스] 0-4. itemService 수행: 33177.03 ms
Before (readAll)
약 5 분
파싱 단독 3분 포함
After (readNext)
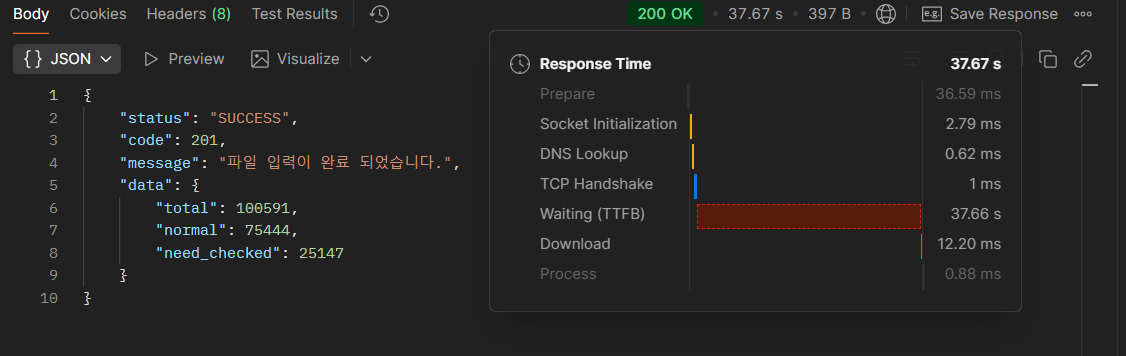
약 40 초
파싱 단독 2초로 감소

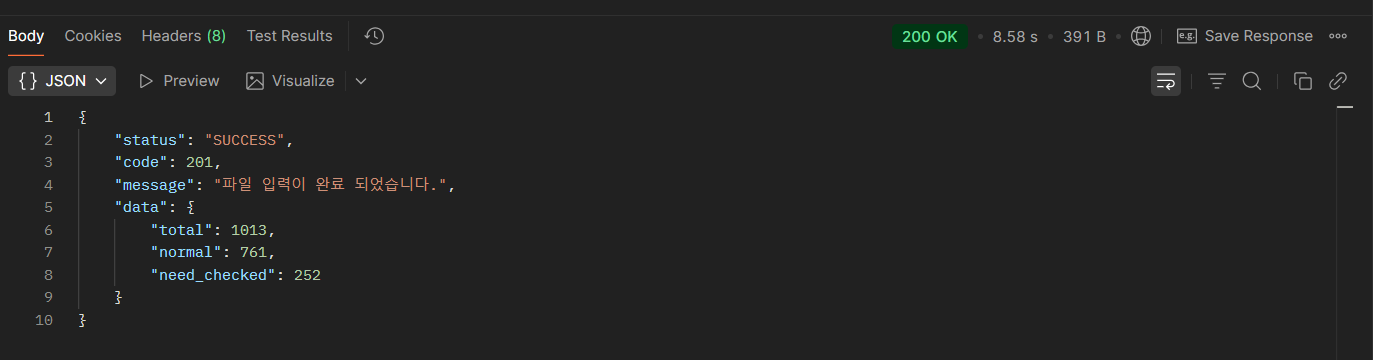
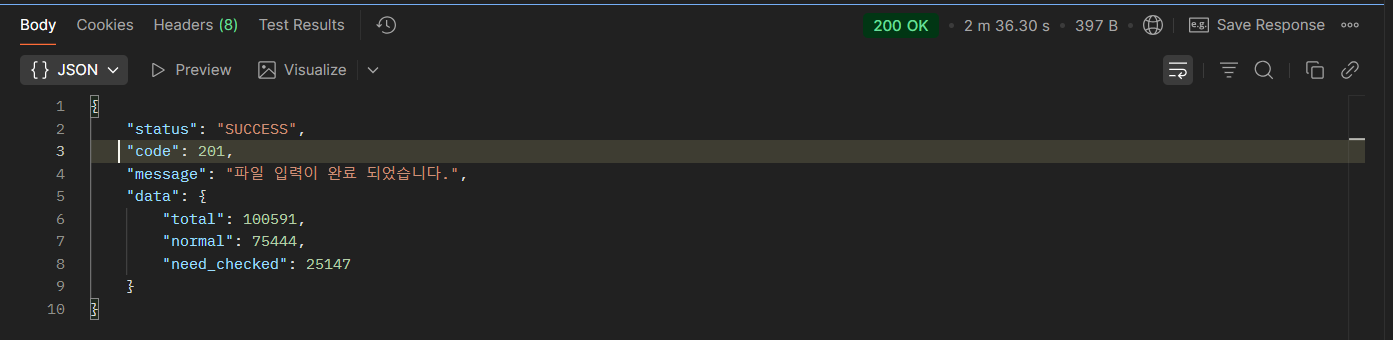
개선 후 응답 결과
추가 개선 — Batch Size 별 파싱 + 저장 (Consumer 방식)

리스트에 모든 데이터를 담지 않고 정해진 Batch Size 별로 파싱 후 DB에 저장하는 방식이다.

🔄 parseAndConsume 1,000 건 단위로 파싱 후 즉시 저장
java
public void parseAndConsume(MultipartFile file,
    Consumer<List<CreateCommonItemDocumentReqDto>> batchConsumer) {

    int batchSize = 1000;
    List<CreateCommonItemDocumentReqDto> buffer = new ArrayList<>(batchSize);

    try (CSVReader csvReader = ...) {
        String[] row;
        long rowNo = 0;
        csvReader.readNext(); // 헤더 스킵

        while ((row = csvReader.readNext()) != null) {
            rowNo++;
            // ... DTO 생성 후 buffer 에 추가
            buffer.add(dto);

            // 1,000개 모이면 즉시 저장 후 버퍼 비우기
            if (buffer.size() >= batchSize) {
                batchConsumer.accept(buffer);
                buffer.clear();
            }
        }

        if (!buffer.isEmpty()) batchConsumer.accept(buffer);
    }
}

// ── 서비스 레이어에서 사용 ──
csvParser.parseAndConsume(file, batchList -> {
    documentRepository.batchInsert(batchList); // JdbcTemplate.batchUpdate 실행
});
💭
위 Consumer 방법을 사용하려면 현재 List<> 에 모든 입력 데이터를 담고 중복 로직을 수행하는 방식을 함께 수정해야 적용이 가능하다. List 기반 중복 로직을 개선해 나가면서 적용해볼 예정이다.

5. 앞으로 개선 사항

[서비스] 1. 검증 및 매핑: 4380.66 ms
[서비스] 2. 연관 관계 구성: 3947.84 ms
[서비스] 3. 이상 탐지 및 이슈 수집: 6501.81 ms
[서비스] 4. DB 커밋: 18339.77 ms
[서비스] 5. 총 시간: 33170.79 ms
📌
파싱 개선 이후에도 10만 건 기준 전체 입력 시간이 약 40초 정도 걸린다. 이 응답 시간은 추가 개선이 필요하며, 계속해서 개선을 진행할 예정이다.

참고

📖
처음에는 입력 데이터 간의 중복 탐지를 DB 임시 테이블에 저장 후 탐지하는 방법을 고려했다.
하지만 아래 문제가 발생할 수 있다고 판단하여 적용하지 않았다.
  1. 변하지 않아야 하는 DB 데이터의 무결성이 깨진다.
  2. 여러 클라이언트가 동시에 파일을 올릴 경우 데이터들 간의 정합성이 깨질 수 있다.
따라서 입력 데이터 간 중복 탐지는 애플리케이션 메모리 레벨에서만 처리하는 방향으로 개선하였다.

'프로젝트 > 보살핌 프로젝트' 카테고리의 다른 글

2. 입력 최적화  (0) 2026.08.31
1. 이상 탐지 리팩토링  (0) 2026.08.27
0. 해커톤 개요  (0) 2026.08.25
Bulk Insert 적용으로 대용량 입력 성능 개선하기

1. 개요

이전 포스트에서 본 것과 같이 수많은 row 를 가진 파일이 입력되는 경우, 해당 row 개수 만큼 INSERT 문이 실행되어 입력에 시간이 매우 오래 걸리는 상황이 발생했다.

이를 해결하기 위해 노력한 과정을 공유하고자 한다.

2. 현재 상황 살펴보기

java
List<DuplicatedGroup> newGroupsToSave = itemsToSave.stream()
    .map(Item::getDuplicatedGroup)
    .filter(group -> group != null && group.getId() == null)
    .distinct()
    .toList();

if (!newGroupsToSave.isEmpty()) {
    duplicatedGroupRepository.saveAll(newGroupsToSave);
}

if (!existingItemsToUpdate.isEmpty()) {
    itemRepository.saveAll(existingItemsToUpdate);
}

// ← 이 부분!
List<Item> savedItems = itemRepository.saveAll(itemsToSave);

if (!issues.isEmpty()) {
    issueRepository.saveAll(issues);
}

return savedItems;
saveAll() 은 한번에 저장하는 것처럼 보이지만, 사실 리스트 내의 값을 하나씩 읽어와서 각각 INSERT 한다.

또한 해당 리스트 내부의 값은 아래 과정을 거치고 저장된다.

[파싱] → [컬렉션 메모리에 임시 저장] → [이상 탐지] → [DB insert]

10만 개와 같은 대용량 데이터에 대해 위 과정을 모두 적용한다면 적지 않은 메모리 사용과 시간이 소요될 것이다.


3. saveAll() 개선하기

부분부분 개선이 가능한 부분부터 접근한다. saveAll() 은 리스트 내부의 모든 요소에 대해 INSERT 문을 실행하기 때문에 이를 수정해서 성능을 개선해보고자 한다.

⚡ Bulk Insert
개념 여러 행을 한 번의 INSERT 문으로 삽입
장점 트랜잭션 수 감소, 리소스 사용 최적화
단점 트랜잭션이 매우 커짐. 오류 발생 시 전체 삽입 실패 가능
🗂️ LOAD DATA INFILE
개념 외부 CSV 파일을 MySQL 테이블에 직접 로드
장점 Bulk Insert 보다 빠름. 앱 메모리 거의 미사용 (OOM 없음)
단점 트랜잭션 관리 어려움. 비즈니스 로직 적용 불가. 파일 형식 종속
🤔
의사 결정
현재 프로젝트에서는 들어오는 데이터에 대해 비즈니스 로직을 수행함과 동시에 입력 시간 단축 및 메모리 절약도 필요하기 때문에 Bulk Insert 를 적용해보기로 했다.
💭
추가 고려 사항
CSV 파일의 경우는 LOAD DATA INFILE 로 미리 데이터를 받고, 받은 데이터를 기반으로 비즈니스 로직을 수행하는 것도 고려해봤다.
수행 시 CSV 입력은 별도 서비스 코드로 분리될 것으로 예상된다. 다른 branch 작업 예정

4. Bulk Insert 적용해보기

  • 테이블 간 여러 관계가 존재하기 때문에 이 또한 함께 고려해야 한다.
  • JDBC 와 JPA 를 같이 쓰게 되면 영속성 관리에 더 신경을 써야 한다.
  • Item 의 자식 테이블인 Issue 역시 JDBC 를 사용해야 정상 적용이 된다.
💾 ItemBulkRepository.java JDBC batchUpdate — Item 벌크 입력
java
@Repository
@RequiredArgsConstructor
public class ItemBulkRepository {
    private final JdbcTemplate jdbcTemplate;

    @Transactional
    public void saveAllItemsInBatch(List<Item> items, int batchSize) {

        String sql =
            "INSERT INTO `items` (\n"
            + "  `effective_date`, `duplicated_group_id`, `file_id`, `price_after`, `price_before`,\n"
            + "  `row_no`, `doc_id`, `normalized_item_name`, `raw_item_name`, `spec`,\n"
            + "  `supplier_name`, `unit`, `review_status`, `source_type`, `created_at`\n"
            + ") VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, NOW())";

        jdbcTemplate.batchUpdate(sql, items, batchSize,
            (PreparedStatement ps, Item item) -> {
                ps.setObject(1, item.getEffectiveDate()); // LocalDate → setObject

                if (item.getDuplicatedGroup() != null)
                    ps.setLong(2, item.getDuplicatedGroup().getId());
                else
                    ps.setNull(2, java.sql.Types.BIGINT);

                if (item.getFile() != null)
                    ps.setLong(3, item.getFile().getId());
                else
                    ps.setNull(3, java.sql.Types.BIGINT);

                ps.setLong(4,  item.getPriceAfter());
                ps.setLong(5,  item.getPriceBefore());
                ps.setLong(6,  item.getRowNo());
                ps.setString(7,  item.getDocId());
                ps.setString(8,  item.getNormalizedItemName());
                ps.setString(9,  item.getRawItemName());
                ps.setString(10, item.getSpec());
                ps.setString(11, item.getSupplierName());
                ps.setString(12, item.getUnit());
                ps.setString(13, item.getReviewStatus() != null
                    ? item.getReviewStatus().name() : null);  // Enum → setString
                ps.setString(14, item.getSourceType() != null
                    ? item.getSourceType().name() : null);
            }
        );
    }
}
LocalDate 타입은 setObject 로, Enum 타입은 setString 으로 설정이 가능하다.
created_at 을 직접 설정한 이유는, JDBC 로 입력하는 단계에서는 JPA 영속성 컨텍스트에 포함되지 않기 때문이다.
⚠️
Issue 도 함께 JDBC Bulk Insert 를 적용해야 한다.
Item 을 JDBC 로 입력하면 JPA 영속성 컨텍스트의 관리를 받지 않기 때문에, 영속성 전이 (Cascade) 나 자동 FK 매핑을 사용할 수 없다.
따라서 자식 객체인 Issue 또한 동일하게 JDBC Bulk Insert 방식으로 직접 부모 ID 를 참조시켜 저장해야 한다.

5. 성능 테스트

5-1. 응답 시간 테스트

1,000 row 파일 입력

Before (JPA saveAll)
8 s
1,000 row 신규 입력
After (Bulk Insert, batch=1000)
2 s
동일 파일 — 400% 속도 개선

Before

After

🚨
트러블 슈팅 : 동일 데이터를 한 번 더 넣으면 서버 에러 발생
java
if (!existingItemsToUpdate.isEmpty()) {
    itemBulkRepository.saveAllInBatch(existingItemsToUpdate); // ← 문제 지점
}
existingItemsToUpdate 는 원래 JPA 변경 감지(Dirty Checking) 로 UPDATE 되어야 하는 항목인데, saveAllInBatch 는 INSERT 를 실행하기 때문에 기존 데이터를 또 생성하려다 에러가 발생한 것이다.

10만 row 파일 입력

조건 소요 시간 비고
Before (JPA saveAll) 1시간 이상 측정 불가
After (batch = 1,000) 약 3 분 결과 확인 가능 수준
After (batch = 5,000) 약 2 분 1분 단축 — 단, 메모리 부하 및 롤백 어려움 증가

batch = 1,000


batch = 5,000

💡
정상적인 JDBC 설정이면 10만 건은 약 5초 내에 완료되어야 한다고 한다.
현재 시간이 오래 걸리는 원인은 각 row 에 대한 중복 검사 로직 때문이며, 이 또한 개선해야 할 사항이다.

5-2. 메모리 측정 (VisualVM)

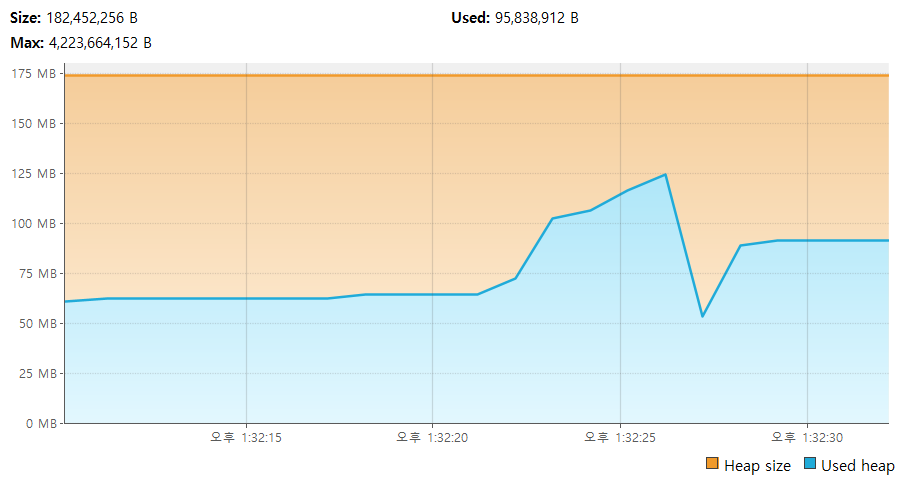
1,000 row 샘플 (Batch Size 5,000)

Before
최대 150 MB
Heap 점유
After
최대 125 MB
Heap 점유

Before


After

최대 Heap 점유 용량과 점유 시간 모두 확실히 유의미한 개선 효과가 보인다.

Batch Size 가 크면 메모리도 많이 점유하기 때문에 적절한 조절이 필요하다.

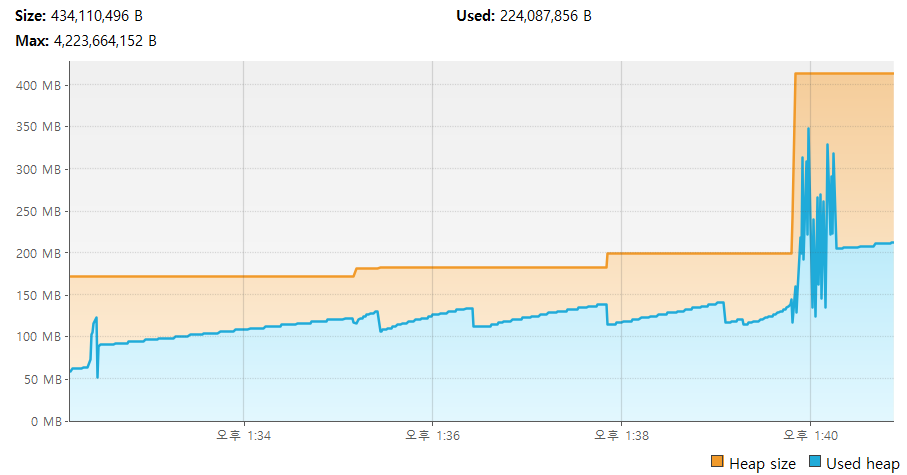
10만 row 샘플 (Batch Size 5,000)

Before (측정 중단)
최대 650 MB
Heap 점유
After
최대 350 MB
Heap 점유 — 약 46% 감소

Before


After

메모리 점유 사용률이 약 46% 감소했다.

특정 구간에서 사용량이 올라간 것은 중복 탐지 로직의 Java Collection 사용으로 인한 현상으로 보인다.

🙂
이렇게 메모리 테스트도 진행해 보았다.
비록 현업에서는 더 고도화되고 체계적으로 테스트하겠지만, 성능 측정에 있어서도 더 배우고 개선해 나가는 개발자로 성장하고 싶다.

NEXT TO DO

  • 중복 검사 로직이 병목 원인임을 확인했으므로, 다음 포스트에서 이를 개선할 예정이다.
  • Bulk Insert 를 처음 적용해보았지만 아직 부족한 점이 많아 추가 학습이 필요하다.
  • 대용량 처리 프레임워크인 Spark, Hadoop, Kafka 와 같은 기술도 공부해보면 좋을 것 같다.
  • JPA 와 JDBC 를 함께 쓸 때 영속성 관리 측면에서 신경 써야 할 점이 많다는 것을 느꼈고, 관련 학습이 필요하다.

'프로젝트 > 보살핌 프로젝트' 카테고리의 다른 글

3. 중복 탐지 로직 최적화 (1)  (0) 2026.09.03
1. 이상 탐지 리팩토링  (0) 2026.08.27
0. 해커톤 개요  (0) 2026.08.25
이상 탐지 로직 리팩토링 & 성능 테스트
SRP 기반 메서드 분리 · 대용량 데이터 성능 측정 · VisualVM · Spring Boot

1. 개요

현재 구매 물품 리스트에 대해서 이상 탐지 로직이 수행될 때 코드가 너무 가독성이 떨어지는 것 같아 이를 리팩토링 하고자 한다.

특히 중복 탐지에 대해서는 현재 들어오는 데이터와 DB 전체의 데이터를 조회해야 하기 때문에, 만약 데이터가 많은 경우 성능 개선이 필요할 것 같아 이를 리팩토링 하고자 한다.

이상 탐지 목록

🔍 필수 값 누락
📐 규격 불일치
📏 단위 불일치
🔁 중복

2. 현재 코드

ItemService.java
java
@Transactional
public List<Item> createCommonItem(List<CreateCommonItemDocumentReqDto> reqDtos, File savedFile) {
    DuplicateValidationResult validationResult =
        itemDocumentDuplicateValidator.markDuplicatesForCommon(reqDtos,
            itemRepository.findAllByDeletedAtIsNullOrderByIdAsc());

    return processAndSaveItemsWithDbCheck(
        reqDtos.size(),
        i -> reqDtos.get(i).getDuplicateGroupKey(),
        validationResult.existingDbMap(),
        (i, group, issueCollector, isDuplicate) -> {
            CreateCommonItemDocumentReqDto dto = reqDtos.get(i);

            ReviewStatus reviewStatus = determineReviewStatus(dto.getSpec(), dto.getUnit(), isDuplicate);

            Set<ConstraintViolation<CreateCommonItemDocumentReqDto>> violations = validator.validate(dto);
            boolean hasMissingField = !violations.isEmpty();
            boolean isDataLacking = dto.getNormalizedItemName() == null;

            if (dto.isHasParseError() || isDataLacking
                    || (reviewStatus.equals(ReviewStatus.NEW)) && hasMissingField) {
                reviewStatus = ReviewStatus.NEEDS_REVIEW;
            }

            Item item = Item.CreateCommonItem(dto, savedFile, group, reviewStatus);
            collectIssuesIfNeeded(item, dto.getSpec(), dto.getUnit(), issueCollector,
                    hasMissingField, isDataLacking);

            return item;
        }
    );
}
processAndSaveItemsWithDbCheck
java
private List<Item> processAndSaveItemsWithDbCheck(
        int size,
        Function<Integer, String> keyExtractor,
        Map<String, Item> existingDbMap,
        QuadFunction<Integer, DuplicatedGroup, Consumer<Issue>, Boolean, Item> itemMapper
) {
    Map<String, DuplicatedGroup> groupMap = new HashMap<>();
    Set<String> seenKeys = new HashSet<>();
    List<Item> itemsToSave = new ArrayList<>();
    List<Item> existingItemsToUpdate = new ArrayList<>();
    List<Issue> issues = new ArrayList<>();

    for (int i = 0; i < size; i++) {
        String duplicateKey = keyExtractor.apply(i);
        DuplicatedGroup group = null;

        if (duplicateKey != null) {
            group = groupMap.computeIfAbsent(duplicateKey, key -> {
                Item originalDbItem = existingDbMap.get(key);
                if (originalDbItem != null) {
                    if (originalDbItem.getDuplicatedGroup() != null) {
                        return originalDbItem.getDuplicatedGroup();
                    }
                    DuplicatedGroup newGroup = DuplicatedGroup.create();
                    originalDbItem.updateDuplicatedGroup(newGroup);
                    existingItemsToUpdate.add(originalDbItem);
                    return newGroup;
                }
                return DuplicatedGroup.create();
            });
        }

        boolean isDuplicate = (duplicateKey != null) &&
                (existingDbMap.containsKey(duplicateKey) || seenKeys.contains(duplicateKey));

        Item item = itemMapper.apply(i, group, issues::add, isDuplicate);
        itemsToSave.add(item);

        if (duplicateKey != null) {
            if (isDuplicate) issues.add(Issue.create(IssueType.DUPLICATE_SUSPECTED, "중복 의심", false, item));
            else seenKeys.add(duplicateKey);
        }
    }

    // ... 저장 로직 생략
    return savedItems;
}
봐도 봐도 한번에 알 수 있는 코드가 아닌 것은 확실하다. 부분 부분 살펴보면서 기능별로 분리해보고자 한다.

SRP (단일 책임 원칙) 을 최대한 준수하면서 리팩토링 해보고자 한다.


3. 메서드 별 분석

ItemService 클래스 내부의 메서드를 확인하면서 각 기능을 분석하고 책임을 분리해보고자 한다.

createCommonItem 메서드 분석

CSV, XLSX 파일이 들어오면 해당 메서드에서 이상 탐지 및 필요한 테이블에 삽입하는 역할을 한다.

  • 1
    DuplicateValidationResult 레코드 클래스를 통해 현재 DB에 저장된 item 의 중복 탐지를 위한 key 값 데이터를 가져온다. 이 과정에서 입력 DTO 의 정규화 item 이름 값이 생성된다.
  • 2
    입력 DTO 의 규격(spec), 단위(unit), 중복 여부(isDuplicated) 를 판단하여 ReviewStatus 값을 정한다.
  • 3
    validator 를 이용하여 필수값 누락을 확인, 그리고 ①에서 정해진 "정규화 item 이름" 이 없는지 확인하여 필수값 누락 탐지를 수행한다.
  • 4
    파싱 실패 시 ③의 이상현상 탐지 결과와 같은 ReviewStatus 값을 부여한다.
  • 5
    Issue 테이블 생성을 위하여 Consumer (issueCollector) 를 활용한다.
💡
Consumer 란?
Java 8 부터 제공되는 java.util.function 패키지의 표준 함수형 인터페이스. 인자를 하나 받아서 로직을 수행하지만, 아무것도 반환하지 않는 (void) 형태이다.
java
Consumer<String> printName = name -> System.out.println("Hello, " + name);

printName.accept("Alice"); // Hello, Alice
printName.accept("Bob");   // Hello, Bob

코드를 분석하면서도 위아래로 왔다갔다 하며 이해하는 데 시간이 오래 걸렸다. 지금부터는 기능별로 정리 후 가독성 높은 코드로 수정해보겠다.


4. 필요 기능 리스트 업

파일 업로드에 대한 필요 기능을 리스트 업 한다. 최대한 작은 단위로 기능을 정리할 것이다.
  • 1
    아이템 이름 → 정규화 이름 매핑
  • 2
    입력된 파일의 row 들과 기존 DB 의 row 들을 비교 (키 만들기)
  • 3
    중복 탐지
  • 4
    기타 이상 탐지 (필수 값 누락, 규격 및 단위 불일치)
  • 5
    이상탐지에 대한 Issue 생성 및 DB 저장 (이슈는 여러 개 생성 가능)
  • 6
    Item 생성 및 DB 저장 (⑤와 함께 수행되어야 함)

5. 본격 리팩토링

최대한 서비스 메서드 내부에 간결한 메서드 호출로 작성하려고 노력하였다.

ItemService.java — 리팩토링 후 서비스 메서드
java
@Transactional
public List<Item> createCommonItem(List<CreateCommonItemDocumentReqDto> reqDtos, File savedFile) {

    // 1. 검증 및 중복 매핑 결과 취득
    DuplicateValidationResult validationResult =
        itemDocumentDuplicateValidator.markDuplicatesForCommon(
            reqDtos, itemRepository.findAllByDeletedAtIsNullOrderByIdAsc()
        );

    List<Item> existingItemsToUpdate = new ArrayList<>();
    List<Boolean> isDuplicateFlags = new ArrayList<>();

    // 2. DTO -> Item 엔티티 및 DuplicatedGroup 연관관계 구성
    List<Item> itemsToSave = processItemsAndGroups(
        reqDtos, validationResult, savedFile, existingItemsToUpdate, isDuplicateFlags
    );

    // 3. 기타 이상 탐지 및 이슈(Issue) 수집
    List<Issue> issues = detectIssues(itemsToSave, reqDtos, isDuplicateFlags);

    // 4. 데이터 일괄 저장 (Item, Issue, Group 등)
    return saveAllEntities(itemsToSave, existingItemsToUpdate, issues);
}
📦 processItemsAndGroups DTO → Item 변환 + 그룹 연관 관계 구성
java
private List<Item> processItemsAndGroups(
        List<CreateCommonItemDocumentReqDto> reqDtos,
        DuplicateValidationResult validationResult,
        File savedFile,
        List<Item> existingItemsToUpdate,
        List<Boolean> isDuplicateFlags
) {
    Map<String, DuplicatedGroup> groupMap = new HashMap<>();
    List<Item> items = new ArrayList<>();
    Set<String> seenKeys = new HashSet<>();

    for (CreateCommonItemDocumentReqDto dto : reqDtos) {
        String groupKey = dto.getDuplicateGroupKey();
        DuplicatedGroup group = resolveDuplicatedGroup(
            groupKey, groupMap, validationResult.existingDbMap(), existingItemsToUpdate
        );

        boolean isDuplicated = (groupKey != null) &&
                (validationResult.existingDbMap().containsKey(groupKey) || seenKeys.contains(groupKey));

        if (groupKey != null) seenKeys.add(groupKey);
        isDuplicateFlags.add(isDuplicated);

        Set<ConstraintViolation<CreateCommonItemDocumentReqDto>> violations = validator.validate(dto);
        boolean hasMissingFieldOrDataLacking =
            !violations.isEmpty() || (dto.getNormalizedItemName() == null);

        ReviewStatus reviewStatus = determineReviewStatusV2(
            dto.getSpec(), dto.getUnit(), isDuplicated, hasMissingFieldOrDataLacking
        );

        items.add(Item.CreateCommonItem(dto, savedFile, group, reviewStatus));
    }
    return items;
}
🔍 resolveDuplicatedGroup 중복 그룹 결정 (3가지 케이스)
java
private DuplicatedGroup resolveDuplicatedGroup(
        String groupKey,
        Map<String, DuplicatedGroup> groupMap,
        Map<String, Item> existingDbMap,
        List<Item> existingItemsToUpdate
) {
    if (groupKey == null) return null;

    return groupMap.computeIfAbsent(groupKey, key -> {
        Item originalDbItem = existingDbMap.get(key);

        if (originalDbItem != null) {
            // Case 1: 기존 DB 항목에 이미 중복 그룹이 존재
            if (originalDbItem.getDuplicatedGroup() != null)
                return originalDbItem.getDuplicatedGroup();

            // Case 2: DB 항목은 있지만 중복 그룹 없음 → 새 그룹 생성 후 업데이트
            DuplicatedGroup newGroup = DuplicatedGroup.create();
            originalDbItem.updateDuplicatedGroup(newGroup);
            existingItemsToUpdate.add(originalDbItem);
            return newGroup;
        }

        // Case 3: DB 항목 없이 요청 DTO 간 내부 중복
        return DuplicatedGroup.create();
    });
}
⚠️ detectIssues 4가지 이상 탐지 → Issue 수집
java
private List<Issue> detectIssues(
        List<Item> itemsToSave,
        List<CreateCommonItemDocumentReqDto> reqDtos,
        List<Boolean> isDuplicateFlags
) {
    List<Issue> issues = new ArrayList<>();

    for (int i = 0; i < itemsToSave.size(); i++) {
        Item item = itemsToSave.get(i);
        CreateCommonItemDocumentReqDto dto = reqDtos.get(i);
        boolean isDuplicated = isDuplicateFlags.get(i);

        // 1. 규격(Spec) 불일치
        if (itemSpecAndUnitValidator.isSpecMismatch(dto.getSpec()))
            issues.add(Issue.create(IssueType.SPEC_MISMATCH, "규격 불일치", false, item));

        // 2. 단위(Unit) 불일치
        if (itemSpecAndUnitValidator.isUnitMismatch(dto.getUnit()))
            issues.add(Issue.create(IssueType.UNIT_MISMATCH, "단위 불일치", false, item));

        // 3. 필수값 누락
        boolean hasMissingField = !validator.validate(dto).isEmpty();
        boolean isDataLacking = (dto.getNormalizedItemName() == null);
        if (isDataLacking || hasMissingField)
            issues.add(Issue.create(IssueType.MISSING_REQUIRED, "필수값 누락", false, item));

        // 4. 중복 의심 (후속 중복 항목일 때만)
        if (isDuplicated)
            issues.add(Issue.create(IssueType.DUPLICATE_SUSPECTED, "중복 의심", false, item));
    }
    return issues;
}
💾 saveAllEntities 순서 보장 일괄 저장
java
private List<Item> saveAllEntities(
        List<Item> itemsToSave,
        List<Item> existingItemsToUpdate,
        List<Issue> issues
) {
    // 1. 아직 저장되지 않은(id == null) DuplicatedGroup 우선 저장
    List<DuplicatedGroup> newGroupsToSave = itemsToSave.stream()
        .map(Item::getDuplicatedGroup)
        .filter(g -> g != null && g.getId() == null)
        .distinct().toList();

    if (!newGroupsToSave.isEmpty())
        duplicatedGroupRepository.saveAll(newGroupsToSave);

    // 2. 새 그룹이 할당된 기존 DB Item 업데이트
    if (!existingItemsToUpdate.isEmpty())
        itemRepository.saveAll(existingItemsToUpdate);

    // 3. 신규 Item 저장
    List<Item> savedItems = itemRepository.saveAll(itemsToSave);

    // 4. Issue 저장
    if (!issues.isEmpty())
        issueRepository.saveAll(issues);

    return savedItems;
}
🏷️ determineReviewStatusV2 ReviewStatus 우선순위 결정
java
private ReviewStatus determineReviewStatusV2(
        String spec, String unit,
        boolean isDuplicated,
        boolean hasMissingFieldOrDataLacking
) {
    // 1순위. 필수값 누락 → NEEDS_REVIEW
    if (hasMissingFieldOrDataLacking) return ReviewStatus.NEEDS_REVIEW;

    // 2순위. 규격/단위 불일치 또는 중복 → ON_HOLD
    boolean hasSpecOrUnitIssue =
        itemSpecAndUnitValidator.isSpecMismatch(spec) || itemSpecAndUnitValidator.isUnitMismatch(unit);

    if (hasSpecOrUnitIssue || isDuplicated) return ReviewStatus.ON_HOLD;

    // 3순위. 이상 없음 → NEW
    return ReviewStatus.NEW;
}
✅
Function 사용을 지양하고 일반 메서드 사용을 추구함으로써 가독성을 높이고자 노력하였다.
아직 코드적으로 개선 사항이 많지만, 아래 6번 성능 이슈로 인해 코드가 완전히 변경될 수 있어 이 정도 리팩토링으로 일단 마무리하고자 한다.

6. 성능 테스트 및 개선 사항

🚨
기능 체크 사항
대용량 파일 입력 (10만 row 이상) + 이상 탐지 프로세스

응답 시간 성능 개선 및 중복 탐지 시 JVM 메모리 오버 가능성이 있으므로 이를 해결해야 한다. (현재 Map 상에 모든 중복 Key 값이 들어가기 때문)

6-1. 응답 시간 측정

데이터 규모 소요 시간 비고
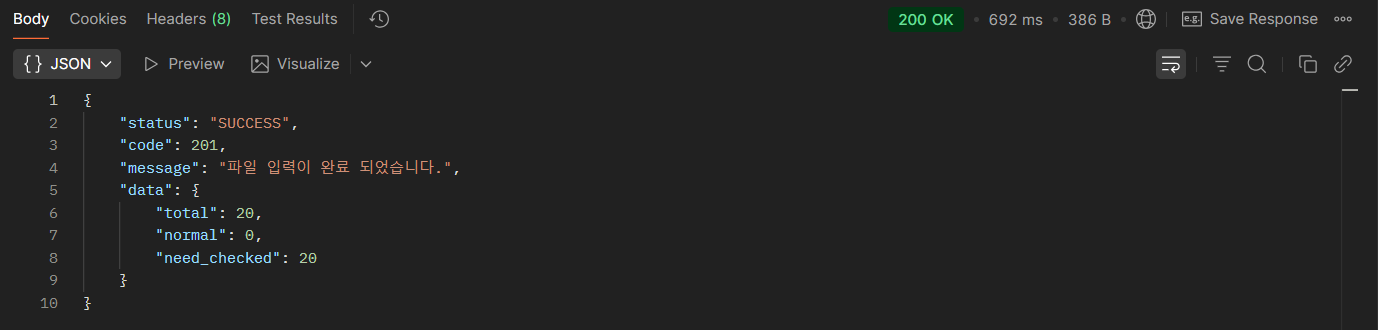
20 row (CSV) 692 ms 파싱 + 중복 판단 포함
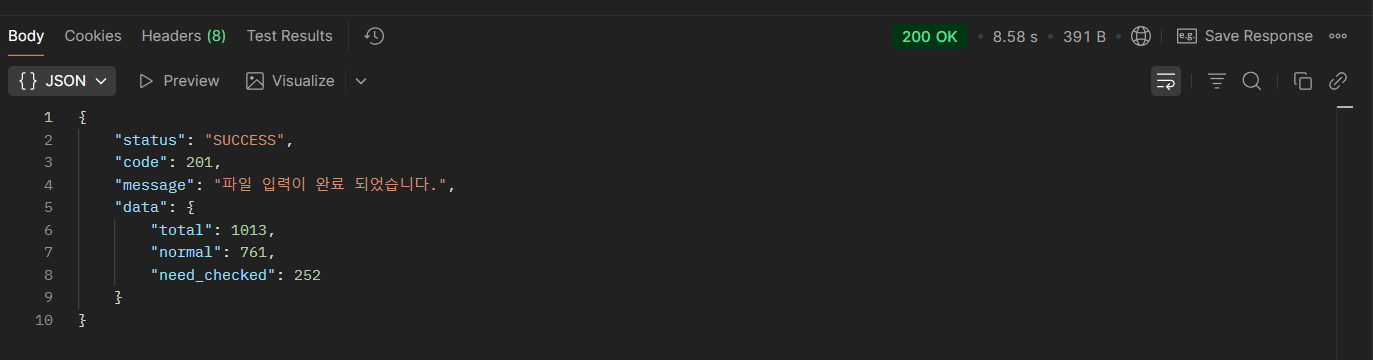
1,000 row (1차) 약 8 s 신규 입력
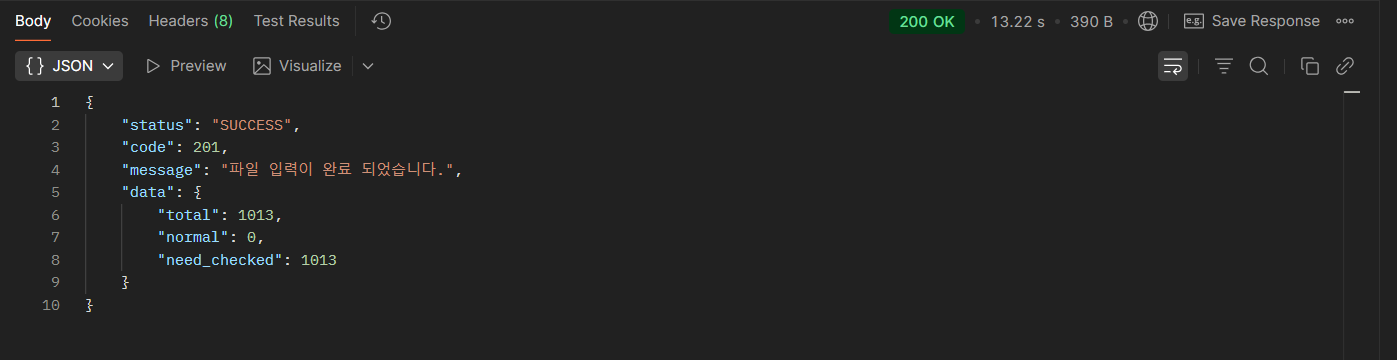
1,000 row (2차) 13.22 s 기존 1,000건과 중복 비교 발생 → 느려짐
1,000 row (3차) 약 8 s 2차 입력분이 update 안 되어 그 시간만큼 단축
10만 row 단순 계산 약 1시간 예상 메모리 오버 + 비효율 발생 확인

20 row 입력 결과


1,000 row 입력 — application.yml 추가 설정 필요

application.yml
yaml
servlet:
  multipart:
    max-file-size: 10MB
    max-request-size: 10MB

⇒ 10만 개의 경우 단순 계산으로 약 1시간 정도 소요 되기에 일단은 1000개의 row 로 테스트 해보았다.


⇒ 1000개의 row 정도는 약 8초 정도 걸렸다.


⇒ 이 이후에 1000개 정도의 데이터를 다시 입력하면 처음 입력보다 더 오래걸린다. (13.22s)

⇒ 이 이후 동일 데이터를 넣어보면 처음과 비슷하게 8초 정도가 소요되는데 이는 처음 입력 데이터 1000개가 update 되지 않기 때문에 그 시간 만큼 덜 소요된 것이다.


하지만 문제는 이 이후이다. 이 1000개의 데이터를 만약 중복 탐지를 위해 메로리 상에 모두 올리게 된다면?


6-2. 메모리 측정 (VisualVM)

* VisualVM 사용법 참고 사이트

📖 Java 성능 모니터링 — VisualVM 분석 및 연동

평소 상태


1,000 row 입력 시

📊
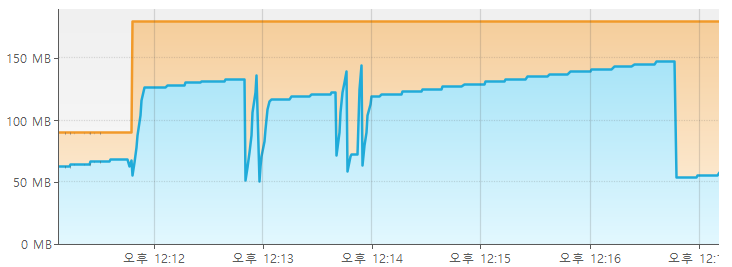
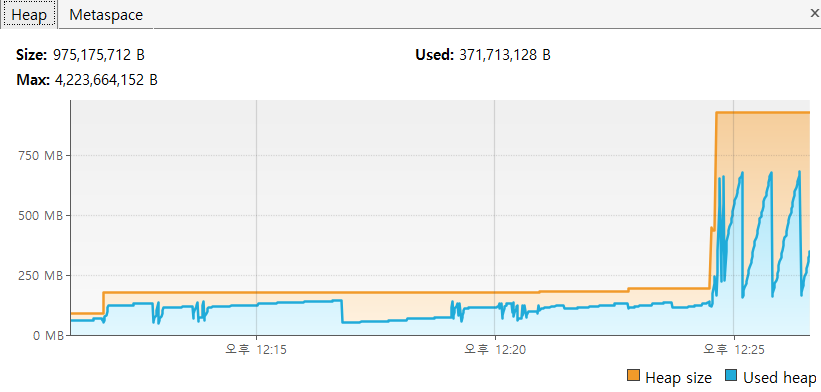
주황 부분이 할당된 Heap 사이즈, 파란 부분이 사용된 Heap 사이즈이다.
보통 50~70% 사이가 안정적인 구간이라고 하는데, 현재 1,000개 정도의 적은 데이터임에도 최대 75% 에 육박하는 그래프를 보인다.
DB 의 데이터가 증가될수록 사용량이 많아질 것이다.

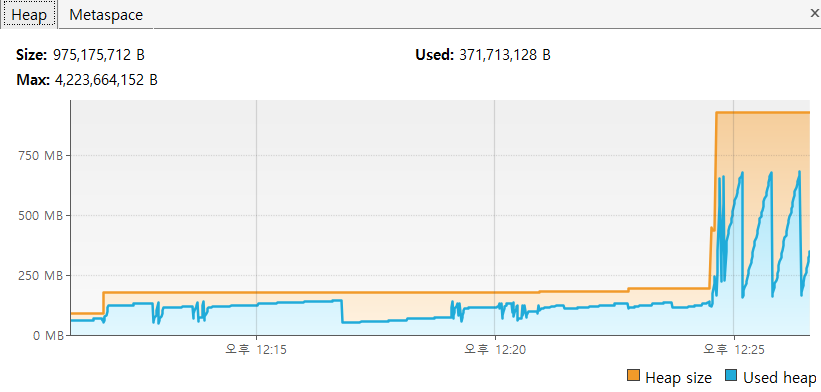
10만 row 입력 시

⚠️
서버의 메모리 자원을 늘리면서 비효율적으로 작업이 진행되는 것을 확인할 수 있다.
🚀
따라서 다음 포스트에서는 위 성능 테스트를 바탕으로 개선을 진행하고자 한다.
이 도전이 DB 관리에 있어서 의미 있는 도전이 되기를 바란다.

'프로젝트 > 보살핌 프로젝트' 카테고리의 다른 글

3. 중복 탐지 로직 최적화 (1)  (0) 2026.09.03
2. 입력 최적화  (0) 2026.08.31
0. 해커톤 개요  (0) 2026.08.25
블레이버스 해커톤 B파트 회고 — 프로젝트 개요
2026.08.02 ~ 2026.08.20 · Spring Boot · OCR · S3

0. 해커톤 개요

해당 해커톤은 앞서 진행된 A 파트 해커톤이 있고 내가 참여한 B 파트 해커톤이 있습니다.

A 파트에서는 창업 아이템을 아이디어톤을 통해 우수한 팀 3팀을 선발하였습니다.
B 파트에서는 A 파트의 우수 3팀의 아이디어를 실제 요구 사항에 맞게 구현하고, 추가적으로 개발 팀별로 아이디어를 적용하는 방식으로 진행되었습니다.

1. 프로젝트 소개

프로젝트 개요

저희는 3개의 아이디어 중 "compozi" 라는 팀의 아이디어를 채택하였습니다.
해당 아이디어는 중소 프랜차이즈 기업의 식자재 유통 관련 아이디어였습니다.
흩어져 있는 구매 증빙 자료를 한곳에 모으고, 해당 자료들의 유효성을 판단하는 부분을 맡게 되었습니다.

해커톤 배경

진행 기간
2026.08.02 ~ 2026.08.20
팀 구성
6명 (PM 1 · UI/UX 1 · FE 2 · BE 2)

아이디어 선정 이유

🤔
팀에서는 AI 관련 전문가가 있는 편이 아니었고, 또한 기본기를 확장하고 싶어하는 사람이 많았기에 해당 아이디어를 구체화시키고 고도화시켜보고자 선정하게 되었습니다.

프로젝트 사이트

🔗 mvp-hackathon-bosalpim

현재 백엔드 서버는 내려가 있어서 기능적으로 실행되지는 않는 상태


2. 전체 아키텍처 개요

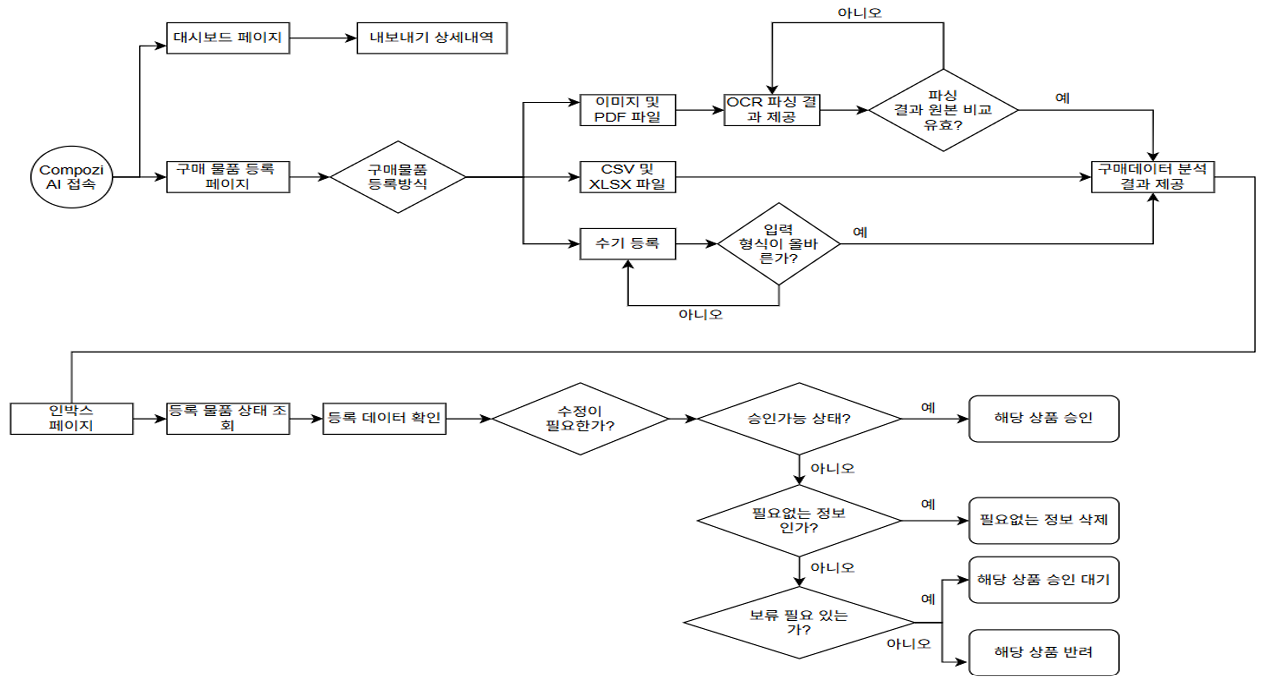
시스템 흐름

정보 입력
→
유효성 검사
→
사용자 검사
→
상태 판단

ERD

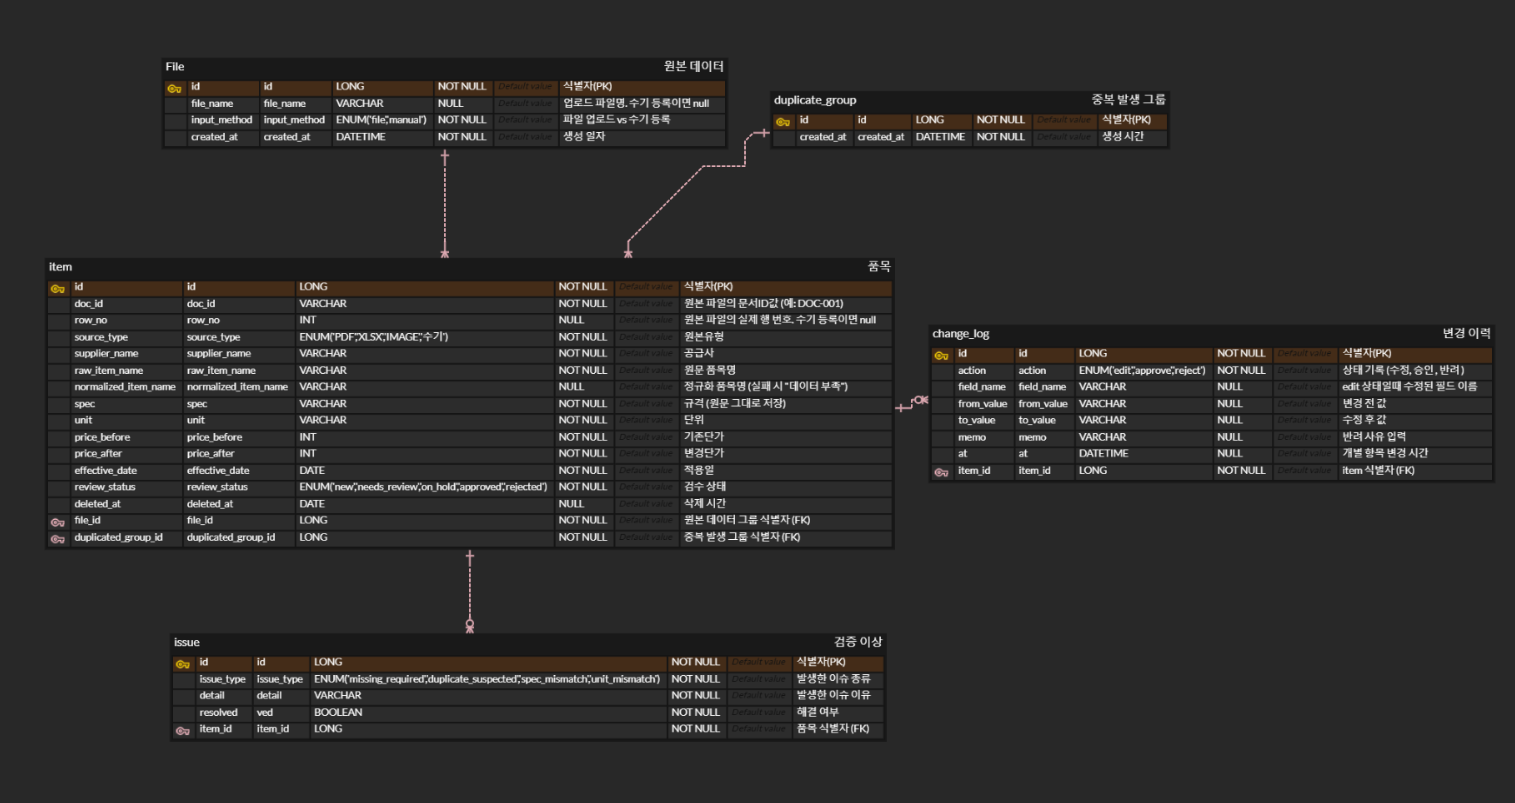
🗂️
구매 품목 (item) 기준으로 검사 및 수정에 따른 여러 테이블이 관계를 맺고 있습니다.

시연 영상 및 발표 자료

🎬 블레이버스 해커톤 — Google Drive

3. 담당 파트

1 파일 입력 시스템 구축

CSV, XLSX 파일을 입력받으면 해당 파일에서 구매 증빙 정보를 파싱하여 DB에 저장합니다.
이 과정에서 각 정보 (row) 들의 유효성 (값 누락, 규격 및 단위 불일치, 중복) 을 파악하고 해당 정보가 기록되도록 했습니다.

2 OCR 연동 및 파일 파싱 확장

CSV, XLSX 파일뿐만 아니라 PDF, PNG 파일과 같은 파일도 해당 시스템에 많이 들어온다고 했습니다.
따라서 해당 기능을 기존 파일 파싱 프로세스에 추가함으로써 유연한 확장이 가능하도록 하였습니다.


4. 기술 스택

영역 기술
Backend Spring Boot, JPA
외부 API Swagger, Naver Clova OCR, Amazon S3
DB MySQL, Amazon RDS
CI/CD Github Actions, Docker

5. 시리즈 로드맵

  • 앞으로의 포스트에서 각 기능 구현 과정을 설명할 것입니다.
  • 이후 해당 기능에 대한 성능 개선 및 오류 개선 관련 포스트도 작성 예정입니다.

'프로젝트 > 보살핌 프로젝트' 카테고리의 다른 글

3. 중복 탐지 로직 최적화 (1)  (0) 2026.09.03
2. 입력 최적화  (0) 2026.08.31
1. 이상 탐지 리팩토링  (0) 2026.08.27
테스트 코드의 종류와 작성 방법
Unit · Integration · E2E · Acceptance Test · Spring Boot / JUnit

0. 들어가기 앞서

항상 테스트 코드 관련해서 테스트 코드의 필요성을 느끼지 못하고 무조건 작성하려고 했던 것 같다. 또한 테스트의 여러 종류를 학습하고 해당 내용을 바탕으로 필요에 맞게 사용하고 싶어서 공부하게 되었다.

1. 테스트 코드의 필요성

💡
가장 큰 이유는 소프트웨어가 의도한 대로 정확하게 동작하는지 확인하기 위함이다.

개발자는 Swagger, Postman 을 통해 직접 API를 호출하거나, QA 과정을 통해 완성된 소프트웨어를 테스트할 수도 있다.

하지만 프로젝트의 규모가 크고 새로운 기능 추가 시에는 비용이 많이 들게 된다.
  • 테스트 코드를 사용하면, 새로운 기능 추가나 리팩토링 과정에서 기존 요구사항에 영향을 주는 부분을 빠르게 발견할 수 있다.
  • 단기적으로 개발 속도가 느릴 수 있어도, 장기적으로는 굉장히 많은 비용을 아낄 수 있다.

2. 테스트 코드 작성 시 중요하게 생각해야 할 부분

1) 구현이 아닌 '행위 (Behavior)' 를 검증

  • 테스트는 내부 코드 구조(How)가 아니라 외부로 드러나는 결과(What)를 검증해야 한다.
  • 구현 방식을 검증하면, 코드 리팩토링 시 기능은 정상 동작해도 테스트가 깨지는 현상 (Fragile Test)이 발생한다.

2) 명확한 구조화 : Given - When - Then

📋
  • Given (준비) : 테스트에 필요한 상태/데이터 정의
  • When (실행) : 검증할 동작/함수 호출
  • Then (검증) : 예상 결과와 실제 결과 비교

3) 경계값과 예외 상황 (Edge & Negative Cases) 검증

  • 성공하는 케이스보다 "실패하거나 예외가 발생하는 상황"을 잘 검증해야 테스트의 가치가 높다.
  • null, 빈값, 최대/최소 범위, 권한 없음 등 예외 상황 시나리오를 반드시 포함해야 한다.

4) 테스트 간의 완전한 격리 (Independence)

  • 각 테스트는 독립적으로 실행 가능해야 하며, 실행 순서에 영향을 받지 않아야 한다. (메서드 단위)
  • 공통 데이터베이스나 전역 변수를 공유해 다른 테스트 결과에 영향을 주는 부작용을 방지해야 한다.

5) F.I.R.S.T 원칙 체크

Fast · 빠름
피드백을 즉시 받을 수 있도록 실행 속도가 빨라야 함.
Isolated · 격리됨
다른 테스트와 독립적이어야 함.
Repeatable · 반복 가능
로컬, CI environment 등 어떤 환경에서도 동일한 결과를 내야 함.
Self-Validating · 자체 검증
성공/실패 여부를 사람이 확인하지 않고 테스트 framework가 스스로 판단함.
Timely · 적시성
실제 production 코드를 작성하기 전이나 작성 직후 바로 테스트를 작성함.

4. 테스트의 종류

💡
  1. 단위 테스트 (Unit Test)
  2. 통합 테스트 (Integration Test)
  3. E2E 테스트 (End-to-End Test)
  4. 인수 테스트 (Acceptance Test)

⇒ 반드시 모든 종류의 테스트가 존재해야 하는 것은 아니다.
종류 범위 속도 주요 도구
단위 테스트 메서드 / 클래스 ⚡ 빠름 JUnit, Mockito
통합 테스트 서비스 ↔ DB 레이어 🐢 보통 @SpringBootTest
E2E 테스트 전체 시스템 Flow 🐌 느림 TestRestTemplate
인수 테스트 비즈니스 요구사항 — BDD 시나리오

5. 단위 테스트 (with JUnit)

💡
  • 개념 : 시스템에서 가장 작은 단위 (메서드, 클래스) 가 의도대로 동작하는지 검증
  • 주요 특징 : 외부 의존성 (DB, API, 네트워크 등) 을 가짜 객체 (Mock, Stub)로 대체하여 독립적으로 테스트함
  • 실행 속도가 빠르며, 실시간 피드백 가능
단위 테스트의 경우는 현재 개인으로 진행 중인 프로젝트의 구현한 테스트 코드 일부를 가져옴 (완벽하지는 않을 수도 있다.)
User 조회 테스트
java
@Test
@DisplayName("예외: 존재하지 않거나 삭제된 회원이면 IllegalArgumentException 이 발생한다.")
void 유저_조회_예외처리() {

    // given
    Long userId = 999L;
    given(userRepository.findByIdAndDeletedAtIsNull(userId)).willReturn(Optional.empty());

    // when & then
    assertThatThrownBy(() -> userService.findUser(userId))
        .isInstanceOf(IllegalArgumentException.class)
        .hasMessage("사용자를 찾을 수 없습니다. ID : " + userId);
}

실제 없는 userId 가 입력되면 조회 시 Optional.empty() 인 빈 값이 나오도록 유도하였고, 해당 서비스의 findUser 메서드를 사용하여 제대로된 예외처리가 이루어지는지 확인하는 코드이다.

given 절에서 일반적인 when 을 사용하는 경우와 달리 given 이라는 키워드를 사용하였는데 이는 BDDMockito 를 사용한 예시이다.

참고 사항 — Mock 객체를 무조건 사용해야 하는 것은 아니다

User 정보 수정 테스트 (실제 객체 사용)
java
@Test
@DisplayName("성공 : 회원 정보 수정 정상 수행")
void 유저_정보_수정() {

    // given
    Long userId = 1L;
    User realUser = User.builder()
        .username("박태우")
        .phoneNumber("010-1234-5678")
        .email("wootaepark@naver.com")
        .build();

    given(userRepository.findByIdAndDeletedAtIsNull(userId)).willReturn(Optional.of(realUser));

    ModifyUserReqDto reqDto = ModifyUserReqDto.builder()
        .phoneNumber("010-1111-2222")
        .build();

    // when
    UpdateUserResDto response = userService.modifyUser(userId, reqDto);

    // then
    assertThat(realUser.getPhoneNumber()).isEqualTo("010-1111-2222");
    assertThat(response).isNotNull();
}

유저 정보를 수정하고 해당 객체의 수정이 제대로 이루어졌는지 확인하기 위해서는 mock 객체보다는 실제 객체 사용이 필요하다.

이외 단위 테스트에 대한 자세한 공부는 (ex : JUnit, Mock) 다른 포스트에서 다룰것이다

6. 통합 테스트

💡
  • 개념 : 단위 모듈들이 서로 결합하여 함께 동작할 때 발생하는 상호작용 및 데이터 흐름을 검증
  • 주요 특징
    • 실제 DB 연동, 파일 시스템 접근, 외부 서비스와의 연결 부위에서 에러가 없는지 확인함.
    • 단위 테스트보다 구성이 복잡하고 실행 시간이 상대적으로 오래 걸림
  • 예시 : 회원 가입 서비스 실행 시, 실제 DB 테이블에 사용자 레코드가 올바르게 저장되는지 검증
통합 테스트 예시 코드
java
@SpringBootTest     // Spring Context 전체를 로드하여 통합 테스트 환경 구축
@Transactional      // 테스트 완료 후 DB 데이터를 자동으로 Rollback
class UserServiceIntegrationTest {

    @Autowired
    private UserService userService;

    @Autowired
    private UserRepository userRepository;

    @Test
    @DisplayName("회원가입 신청 시 DB에 정상 저장되고 DTO가 반환되어야 한다")
    void registerUser_Success() {
        // Given
        UserRegisterRequest request = new UserRegisterRequest("hong", "hong@example.com");

        // When
        UserResponse response = userService.registerUser(request);

        // Then
        assertThat(response.getId()).isNotNull();
        assertThat(response.getName()).isEqualTo("hong");

        // DB 직접 조회 검증
        User savedUser = userRepository.findById(response.getId()).orElse(null);
        assertThat(savedUser).isNotNull();
        assertThat(savedUser.getEmail()).isEqualTo("hong@example.com");
    }
}

실제 데이터베이스와 연결하여 (Service → Repository → DB) 로 이어지는 레이어 간 연동을 검증한다.

실행 시 실제 Spring Boot 어플리케이션이 실행되며 실행 속도가 느린 편이다. (+ 실제 객체 사용)


7. E2E 테스트

💡
  • 개념 : 사용자 관점에서 시스템의 처음부터 끝까지 전체 흐름(Flow)이 올바르게 작동하는지 검증
  • 주요 특징
    • UI, 백엔드 API, DB 등 실제 운영 환경과 유사한 조건에서 진행
    • 시스템의 전체적인 신뢰도는 높여주지만, 실행 속도가 가장 느리고 테스트 유지보수 비용이 높다.
  • 예시 : 로그인 → 아이디/비번 입력 → 대시보드 이동 → 장바구니 → 결제 까지의 전체 흐름을 브라우저 자동화 도구로 검증
E2E 테스트 코드 예시
java
// RANDOM_PORT: 실제로 톰캣(Embedded Tomcat) 서버를 포트에 띄움
@SpringBootTest(webEnvironment = SpringBootTest.WebEnvironment.RANDOM_PORT)
class OrderE2ETest {

    // 실제 HTTP 요청을 보낼 클라이언트 객체
    @Autowired
    private TestRestTemplate restTemplate;

    @Autowired
    private OrderRepository orderRepository;

    @Test
    @DisplayName("[E2E] 실제 HTTP POST 요청을 보내 주문을 생성하고 DB 저장까지 확인한다")
    void createOrder_E2E_Success() {
        // Given
        OrderRequest request = new OrderRequest("ITEM-001", 2, 30000);

        // When: 실제 서버 엔드포인트 `/api/orders` 로 HTTP POST 요청 전송
        ResponseEntity<OrderResponse> response = restTemplate.postForEntity(
            "/api/orders",
            request,
            OrderResponse.class
        );

        // Then 1: HTTP 응답 상태 및 Body 검증
        assertThat(response.getStatusCode()).isEqualTo(HttpStatus.CREATED);
        assertThat(response.getBody()).isNotNull();
        assertThat(response.getBody().getItemCode()).isEqualTo("ITEM-001");
        assertThat(response.getBody().getTotalPrice()).isEqualTo(60000);

        Long createdOrderId = response.getBody().getOrderId();

        // Then 2: 실제 DB에 데이터가 올바르게 영속화되었는지 조회하여 확인
        Order savedOrder = orderRepository.findById(createdOrderId).orElse(null);
        assertThat(savedOrder).isNotNull();
        assertThat(savedOrder.getQuantity()).isEqualTo(2);
    }
}

통합 테스트와 같이 실제 객체들로 테스트하며, 사용자 입장에서 하나의 서비스 flow 전체를 테스트하는 것과 같다.

여러 의존성 및 라이브러리를 가져와서 사용하기 때문에 제일 무거운 테스트


8. 인수 테스트

📋
  • 개념 : 시스템이 비즈니스 요구사항을 충족했는지 사용자 또는 고객(PO/PM) 관점에서 검증
  • 주요 특징
    • "기술적으로 잘 작동하는가?" 보다 "사용자가 요청한 기능 명세대로 동작하는가?" 에 초점
    • 시나리오 기반(BDD)으로 작성하는 경우가 많으며, 해당 테스트 통과 시 배포/수락 가능한 상태로 판단
  • 예시 : "일반 회원이 쿠폰을 적용하면 최종 결제 금액에서 10% 가 할인되어야 한다" 라는 기획 요구사항을 검증

코드로 작성되기보다는 비즈니스 테스트 관점이 더 크다.


9. 마치며

테스트 코드는 프로젝트 환경과 여건에 맞춰 유연하게 적용해야 함을 배웠다.

기존에는 무조건 단위 테스트 위주로 테스트를 진행해야겠다고 생각했지만, 공부해보면서 무조건 테스트 코드를 작성하기보다는 꼭 필요한 곳에 대한 테스트를 적재적소에 사용해야겠다는 생각이 들었다.

앞으로도 더 많은 프로젝트를 진행하며 이번 이론을 바탕으로 실제 테스트 코드를 더 많이 경험하고 적용하고 싶다.

다음 포스트에는 단위 테스트 중에서 제일 많이 사용되는 JUnit 사용 방법에 대해서 자세히 알아 볼 것이다.

@Value vs @ConfigurationProperties

0. 들어가기 앞서

Spring 에서의 환경 변수 관리 방법이 @Value 를 사용하는 방법만 알고 있었는데, 공부하다 보니 좀 더 체계적으로 관리할 수 있는 방법이 있다는 것을 알게 되어 비교하고 각각의 장단점을 정리해보고자 한다.

0-1. 기본 환경 변수 설정

application.properties
properties
greeting-name=taewoo
greeting-coffee=${greeting-name} is drinking Cafe Cereza
application.yml
yaml
greeting:
  name: taewoo
  coffee: ${greeting.name} is drinking Cafe Cereza

1. @Value 를 사용하는 경우

아래와 같이 POJO 형태의 클래스를 먼저 만들었다.

  • POJO : 특정 기술이나 프레임워크에 종속되지 않은, 순수한 형태의 기본 자바 객체

Coffee.java
java
@Component // 빈 등록 필수
@Getter
public class Coffee {

    @Value("${greeting-name:someone}")
    // @Value("${greeting.name:someone}") → yml 파일의 경우
    // application.properties 의 greeting-name 변수 확인 → 없으면 someone 으로 설정
    private final String name;

    @Value("${greeting-coffee:${greeting-name} is drinking ice coffee}")
    // greeting-coffee 변수 확인 → 없으면 : 뒤의 값으로 설정
    private final String place;

    public Coffee() { // 우선순위 확인을 위한 기본 생성자
        this("기본생성자", "여기 있어요");
    }

    public Coffee(String name, String place) {
        this.name = name;
        this.place = place;
    }
}
테스트 코드
java
@SpringBootTest
class CoffeeServiceTest {

    @Autowired
    private CoffeeService coffeeService;

    @Test
    void getCoffee() {
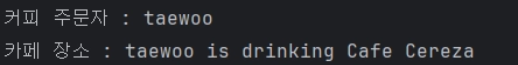
        System.out.println("커피 주문자 : " + coffeeService.getCoffee().getName());
        System.out.println("카페 장소 : " + coffeeService.getCoffee().getPlace());
    }
}
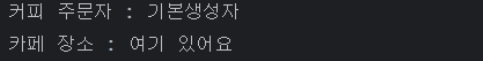
이렇게 기본 생성자가 정의되어 있어도 호출하는 방식에 따라 결과가 다르게 나온다. (개발자 입장에서 헷갈릴 수 있음)

1-1. Spring 컨테이너에 의해 빈으로 생성되는 경우

CoffeeService.java
java
@Service
@RequiredArgsConstructor
public class CoffeeService {

    private final Coffee coffee;

    public Coffee getCoffee() {
        return coffee;
    }
}
💡
동작 과정
  1. Coffee() <기본생성자> 호출
  2. @Value 가 붙은 필드에 설정파일(properties, yml) 의 값을 주입한다.
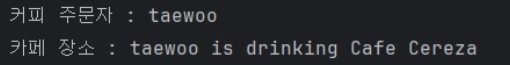
  3. 결과적으로 환경변수가 기존 생성자로 초기화된 값을 덮어쓰게 된다.

결과


1-2. 직접 클래스 호출

CoffeeService.java
java
@Service
public class CoffeeService {

    // bean 을 통해 주입되는 것이 아니라 직접 생성 (@Component 가 있으나 마나)
    private Coffee coffee = new Coffee();

    public Coffee getCoffee() {
        return coffee;
    }
}
⚠️
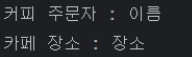
Spring 컨테이너에서 주입받은 (DI) 객체가 아닌 새로 만든 객체이기 때문에 @Value 가 동작하지 않는다.
따라서 일반적인 객체 생성과정과 동일하게 이루어지기 때문에 아래와 같은 결과가 나온다.

결과


1-3. @Value 방식의 단점

❗
  1. 테스트의 어려움
    단위 테스트를 위해 객체 생성 시 Spring 컨텍스트를 반드시 띄워야 한다.
    단순 객체 테스트를 위해 Spring 프레임워크를 의존해야 하여 테스트 속도가 느려진다.
  2. final 키워드와의 충돌
    private final String name; 과 같이 final 로 선언하고 싶어도 @Value 는 Spring 이 객체 생성 후 리플렉션(Reflection API) 을 통해 억지로 집어넣는 방식이다.
    final 은 생성자에서 초기화되어야 하는데 필드 주입은 객체 생성 이후에 발생 → final 사용 불가 또는 런타임 오류 발생 가능
  3. 순환 참조 및 초기화 시점 문제
    @Value 주입 시점은 Bean 생성 완료 이후이다.
    생성자 내부 로직에서 @Value 로 주입받은 변수를 사용하려 하면 주입 전이므로 null 값이 나온다.

하지만 이러한 단점 외에도 간결함 및 빠른 프로토타이핑 (복잡 설정 없이 빠르게 기능 구현하거나, 단순 설정 클래스 만들 때) 생산성이 높다.


1-4. 단점 극복 방안 — @Value 를 이용한 생성자 주입

java
@Component
public class Coffee {
    private final String name;
    private final String place;

    // 생성자 주입
    public Coffee(
        @Value("${greeting-name:someone}") String name,
        @Value("${greeting-coffee:${greeting-name} is drinking ice coffee}") String place
    ) {
        this.name = name;
        this.place = place;
    }
}
✅
효과
  1. 테스트 용이 : new Coffee("이름", "장소"); 로 간단히 단위 테스트 가능
  2. 불변성 보장 : final 필드를 안전하게 사용 가능
  3. 순환 참조 방지 : 객체 생성 시점에 모든 의존성이 주입되므로 초기화 오류 없음
  4. DI 프레임워크 의존성 분리 : Spring 이 아닌 다른 환경에서도 독립적으로 동작 가능

1-5. 생성자 주입의 결과

Value 미동작 일반 객체처럼 사용

java
@Service
public class CoffeeService {

    // 기본생성자 호출 시 컴파일 에러
    private final Coffee coffee = new Coffee("이름", "장소");

    public Coffee getCoffee() { return coffee; }
}

Value 동작 의존성 주입 사용

java
@Service
@RequiredArgsConstructor
public class CoffeeService {

    private final Coffee coffee;

    public Coffee getCoffee() { return coffee; }
}

2. @ConfigurationProperties

사용 의도 : 속성을 정의하고 관련 속성을 그룹화해서, 도구로 검증 가능하고 타입 세이프한 방식으로 속성을 참조하고 사용하기 위함

2-1. 사용해보기

Greeting.java
java
@Getter
@Setter
@ConfigurationProperties(prefix = "greeting")
// greeting.name, greeting.coffee 처럼 application.properties 에 설정 가능
public class Greeting {
    private String name;
    private String coffee;
}
TaepangApplication.java (main)
java
@SpringBootApplication
@ConfigurationPropertiesScan
// @ConfigurationProperties 를 스캔하기 위해 필요 (또는 Greeting 에 @Component 추가)
public class TaepangApplication {
    public static void main(String[] args) {
        SpringApplication.run(TaepangApplication.class, args);
    }
}
CoffeeService.java
java
@Service
@RequiredArgsConstructor
public class CoffeeService {

    private final Greeting greeting; // 의존성 주입

    public Greeting getCoffee() { return greeting; }
}
build.gradle
groovy
implementation 'org.springframework.boot:spring-boot-configuration-processor'
application.properties
properties
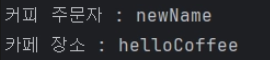
greeting.name=newName
greeting.coffee=helloCoffee
// 위 의존성 추가 이후 재빌드 하면 위와 같이 기본 변수 설정이 가능하다.
테스트 코드
java
@SpringBootTest
class CoffeeServiceTest {

    @Autowired
    private Greeting greeting;

    @Test
    void getCoffee() {
        System.out.println("커피 주문자 : " + greeting.getName());
        System.out.println("카페 장소 : " + greeting.getCoffee());
    }
}

테스트 결과


💡
@Value 와의 차이
  1. 설정(환경 변수)을 하나의 POJO 로 정의할 수 있다.
  2. IDE 의 자동완성 가능
  3. 기본값 관리의 명확성 : 코드 내에서 직접 확인 가능
    java
    @ConfigurationProperties(prefix = "coffee")
    public class CoffeeProperties {
        private String name = "someone";       // 자바 자체의 초기값
        private String place = "drinking ice coffee";
    }
    객체 생성 시점에 이미 초기값이 설정되므로, Spring 이 값을 주입하지 않아도 항상 안전하고 유효한 상태이다.
  4. List, Map, 중첩 객체 등 계층형 구조를 깔끔하게 매핑 가능하다.
  5. @Valid 와 함께 사용하여 시작 시 설정값 검증 가능 (오류 발생 시 서버 중단) — 제일 중요
    java
    @ConfigurationProperties(prefix = "coffee")
    @Validated
    public class CoffeeProperties {
        @NotBlank
        private String name;  // 반드시 값이 있어야 함
    
        @Min(1)
        private int price;    // 가격은 최소 1 이상이어야 함
    }

3. @ConfigurationProperties 의 추가 기능 — 서드 파티 옵션

3-1. 서드 파티란?

📖
서드 파티(Third-party)는 '제3자'를 뜻한다. 원천 기술이나 서비스를 제공하는 당사자(퍼스트 파티)와 이를 이용하는 소비자(세컨드 파티)가 아닌, 외부의 다른 개발자나 기업을 의미 (from 나무위키)

Spring 관점의 서드 파티
  • JDBC / ORM
  • Auth0, Okta
  • Lombok, Swagger
  • Redis, Kafka, AWS SDK

Spring 프로젝트에 외부 의존성을 추가하고 해당 의존성(컴포넌트) 문서를 참조해 스프링 빈을 생성할 때 @ConfigurationProperties 가 유용하게 사용된다.


3-2. 예제 컴포넌트 생성해서 적용해보기

Droid.java
java
@Getter
@Setter
public class Droid { // 외부에서 가져온 서드 파티 컴포넌트라고 가정
    // getter, setter 를 통해 Reflection API 로 환경변수가 설정된다.
    private String id, description;
}
SpringConfig.java — 빈 등록 (수동)
java
@Configuration
public class SpringConfig {

    @Bean
    @ConfigurationProperties(prefix = "droid")
    // 외부 서드파티에 직접 붙일 수 없는 경우 사용 (원래는 클래스 위가 권장)
    Droid droid() {
        return new Droid(); // Setter 를 통해 객체의 설정값 주입
    }
}
application.properties
properties
droid.id=BB-8
droid.description=Small, rolling android, Doesn't drink milk.
테스트 코드
java
@SpringBootTest
class CoffeeServiceTest {

    @Autowired
    private Droid droid;

    @Test
    void getCoffee() {
        System.out.println("드로이드 id : " + droid.getId());
        System.out.println("드로이드 설명 : " + droid.getDescription());
    }
}

결과

이런 식으로 @ConfigurationProperties 를 이용하여 서드 파티 컴포넌트의 환경변수를 설정하고 사용 가능하다.


3-3. Setter 없이 생성자로만 빈 등록해서 사용하기 (서드 파티)

Droid.java — record 클래스로 변경
java
// record 클래스 (@Getter, @RequiredArgsConstructor 포함)
public record Droid(String id, String description) {
    // droid.id(); / droid.description(); 처럼 접근 가능
}

// ─── 아래 코드와 동일함 ───

@Getter
public class Droid {
    private final String id, description;

    public Droid(String id, String description) {
        this.id = id;
        this.description = description;
    }
}

3-3-1. @Value 사용

java
@Configuration
public class SpringConfig {

    @Value("${droid.id:defaultId}")
    private String id;

    @Value("${droid.description:defaultDesc}")
    private String description;

    @Bean
    @ConfigurationProperties(prefix = "droid")
    Droid droid() {
        return new Droid(id, description);
    }
}
💡
환경 변수를 가져와서 생성자를 통해 Bean 등록 (필요 변수)

결과

3-3-2. @ConfigurationProperties 사용

Droid.java 수정
java
@ConfigurationProperties(prefix = "droid")
public record Droid(String id, String description) { }

해당 클래스를 환경변수에 이용한다는 @ConfigurationProperties 설정

SpringConfig.java
java
@Configuration
// 방법 1. Droid 를 빈 등록 (이것만 쓰는 경우 Setter 필수 / @ConfigurationPropertiesScan 없어도 됨)
@EnableConfigurationProperties(Droid.class)
public class SpringConfig {

    // 방법 2. 직접 빈 등록 (Setter 없는 경우 보통 이 방법 사용 / @ConfigurationPropertiesScan 필수)
    @Bean
    Droid droid(Droid dro) {
        return new Droid(dro.id(), dro.description());
    }
}

방법 한 개만 써야 중복 빈 등록이 방지된다. (상황에 맞게 사용)

결과


📌
정리
  • Setter 가 있으면 : @ConfigurationPropertiesScan 없어도 됨. 여러 방법 존재 (위 SpringConfig.java 참고)
  • 생성자를 통해 초기화해야 하면 : @ConfigurationPropertiesScan 필수 (환경 변수 주입이 필요하기 때문)

💡 결론 : 웬만하면 @ConfigurationPropertiesScan 사용하면서 생성자를 통해 초기화하자!!

4. .env 와 @ConfigurationProperties 사용 (TIP)

Greeting.java
java
@Getter
@Setter
@ConfigurationProperties(prefix = "greeting")
public class Greeting {
    private String name;   // GREETING_NAME 매핑
    private String coffee; // GREETING_COFFEE 매핑
}
.env
GREETING_NAME=envName
GREETING_COFFEE=envCoffee
application.properties
properties
# 실제 배포 시 환경 변수로 관리 (해당 파일이 GitHub 에 올라가야 하기 때문)
greeting.name=${GREETING_NAME:someone}
greeting.coffee=${GREETING_COFFEE:americano}

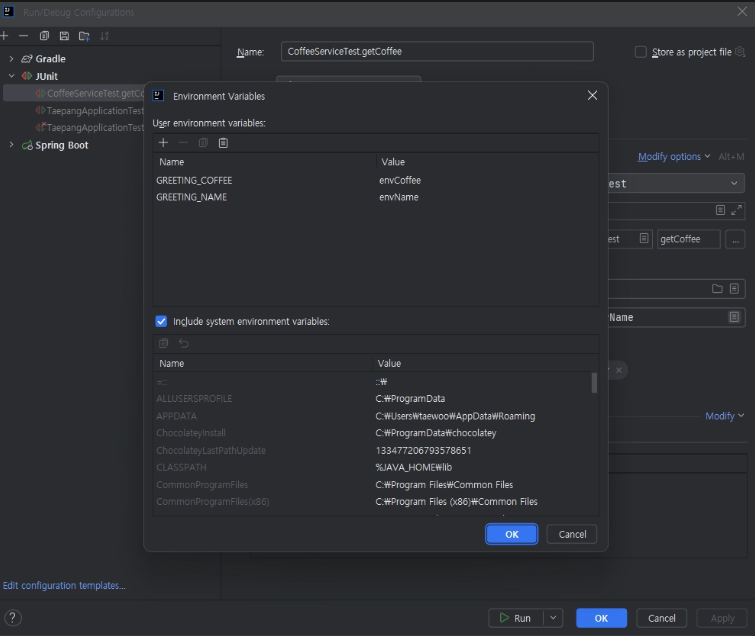
Intellij 설정 (화면 우측 상단의 editConfiguration 설정을 하면 된다.)

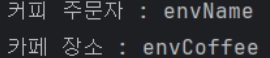
결과


5. 후기

🙂
기존까지는 단순히 @Value 를 쓴 경험뿐이었다. 대부분의 프로젝트나 실습 때 환경변수를 단순히 가져다만 썼기 때문이라고 생각한다.

@ConfigurationProperties 를 쓰는 방법도 알았으니 앞으로 더 복잡한 변수 관리가 필요할 때 유용하게 사용할 수 있을 것 같다.

'Spring boot' 카테고리의 다른 글

[Spring] 테스트 코드 알아보기  (1) 2026.07.22

0. 작성 목적

Spring 프로젝트나 Java 프로젝트를 설계할 때마다 헷갈리는 개념이 추상 클래스와 인터페이스의 명확한 역할이었던 것 같다.
그래서 각각이 어떤 식으로 동작하고 사용되어야 하는지 알아보기 위해 작성한다.
또한 인터페이스에 대한 개념이 부족하다고 생각하여 이참에 정리하고자 작성한다.


1. 상속 vs 포함

본격적으로 둘의 차이를 알아보기 앞서 기본적으로 상속 관계와 포함 관계의 차이에 대해 알아보고자 한다.

// 두 경우 모두 코드 재사용성을 높이는 데 도움을 준다.

// 상속 관계
class Circle extends Point {
    int r;
}

// 포함 관계
class Circle {
    Point c = new Point();
    int r;
}
  • 상속 관계 : 기존의 클래스를 재사용하여 새로운 클래스를 작성. 공통적 관리 가능 및 코드 추가·변경에 용이하다.
  • 포함 관계 : 클래스 내부에 멤버 변수로 다른 클래스 타입의 참조 변수를 선언하는 것. 단위별로 여러 클래스를 작성하기 때문에 재사용성이 높고 클래스를 간결하게 작성할 수 있다.
     

구별하는 법

Circle is a Point. (원은 점이다.)   → 상속 관계
Circle has a Point. (원은 점을 가지고 있다.)  → 포함 관계
  • is-a 관계라면 → 상속
  • has-a 관계라면 → 포함


2. 각각의 정의


2-1. 추상 클래스

개념 : 클래스 내에 추상 메서드가 선언되어 있는 클래스. 미완성 설계도라고 표현할 수 있다.


특징

  1. 추상 클래스도 생성자가 있어야 한다. (자동 생성 가능)
  2. 일반 메서드도 추상 클래스 내부에 선언 및 구현 가능하다.
  3. 메서드 강제 구현을 강요하기 위한 클래스이다.
abstract class AbstractTest {
    abstract void move();
}

 
상속하는 경우

abstract class Parent {
    int x, y;
    abstract void methodA();
    abstract void methodB();
    void stop() { /* 메서드 구현 */ }
}

// 1. 일반 클래스: 모든 추상 메서드를 구현해야 함
class Child1 extends Parent {
    @Override
    void methodA() { /* 구현 */ }
    @Override
    void methodB() { /* 구현 */ }
}

// 2. 추상 클래스: 구현을 안 하거나 일부만 해도 됨
abstract class Child2 extends Parent {
    @Override
    void methodA() { /* methodA만 구현, methodB는 여전히 추상 상태 */ }
}

// 사용 예시
Child1 c1 = new Child1();
c1.methodA();
c1.stop(); // 일반 메서드 사용 가능

  • 일반 클래스로 상속 시에는 모든 추상 메서드를 구현해야 한다.
  • 추상 클래스를 추상 클래스로 상속 시에는 구현을 안 하거나 일부만 해도 된다.
  • 공통된 부분은 미리 추상 클래스 내부에 일반 메서드로 구현함으로써 다형성을 유지할 수 있다. (필드도 마찬가지)


2-2. 인터페이스

개념 : 일종의 추상 클래스이다. 추상 클래스보다 추상화 정도가 높으며, 일반 메서드 또는 멤버 변수를 구성원으로 가질 수 없다. 기본 설계도라고 표현할 수 있다.

특징

  1. 오직 추상 메서드와 상수만을 멤버로 가질 수 있다.
  2. 모든 멤버 변수는 public static final (상수)이어야 하며, 이는 생략 가능하다.
  3. 모든 메서드는 public abstract (추상 메서드)이어야 하며, 이는 생략 가능하다.
  4. 단, static 메서드와 default 메서드는 예외이다.
interface 인터페이스이름 {
    public static final double PI = 3.14; // 상수
    public abstract void methodA();       // 추상 메서드
}


2-3. 인터페이스의 상속

인터페이스는 인터페이스로부터만 상속이 가능하다. 클래스와 달리 다중 상속이 가능하다.

interface Movable {
    void move(int x, int y);
}

interface Attackable {
    void attack(Unit u);
}

interface Fightable extends Movable, Attackable { /* 구현 */ }


2-4. 인터페이스의 구현

추상 클래스처럼 그 자체로는 인스턴스 생성이 불가하며, implements 키워드를 이용하여 구현한다.

// 일반 클래스로 구현
class Fighter implements Fightable {
    public void move(int x, int y) { /* 구현 */ }
    public void attack(Unit u) { /* 구현 */ }
}

// 일부만 구현하는 경우 → 추상 클래스로 선언
abstract class Fighter implements Fightable {
    public void move(int x, int y) { /* 구현 */ }
    // attack()은 미구현 → abstract 클래스여야 함
}

// 상속과 구현을 동시에
class Fighter extends Unit implements Fightable {
    public void move(int x, int y) { /* 구현 */ }
    public void attack(Unit u) { /* 구현 */ }
}


2-5. 인터페이스의 다형성

자식 클래스의 인스턴스를 부모 타입의 변수로 참조하는 것 (업캐스팅)이 가능하듯이, 인터페이스 역시 구현 클래스의 조상이므로 참조가 가능하다.

Fightable f = (Fightable) new Fighter();
// 또는
Fightable f = new Fighter(); // 업캐스팅

// 인터페이스 타입의 참조 변수(f)는 Fightable에 정의된 멤버들만 호출 가능

 
인터페이스의 여러 사용법

// 1. 매개변수로 사용되는 인터페이스
class Fighter extends Unit implements Fightable {
    public void move(int x, int y) { /* 구현 */ }
    public void attack(Fightable f) { /* 구현 */ }
}

// 2. 인터페이스 타입의 반환형
Fightable method() {
    Fighter f = new Fighter();
    return f; // Fighter가 Fightable을 구현한 클래스임을 알 수 있다.
}

💡 핵심 : 리턴 타입이 인터페이스라는 것은 메서드가 해당 인터페이스를 구현한 클래스의 인스턴스를 반환한다는 의미이다.
나중에 Fighter를 리뉴얼한 StrongFighter 클래스로 변경되어도 해당 부분만 바꿔주면 된다. (관리 용이)


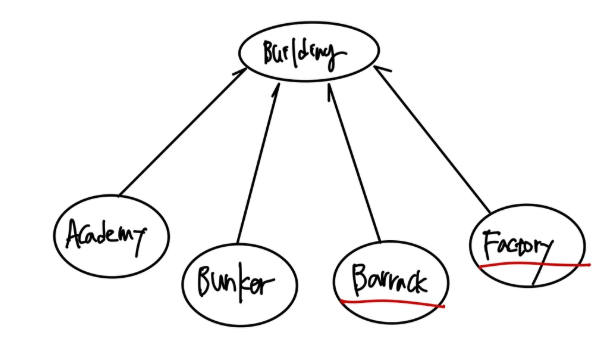
2-6. 인터페이스의 활용 (1) — StarCraft 건물 예시

Barrack, Factory는 건물을 들어 올리는 기능(Lift)이 있는데, 이 기능을 메서드로 추가하고자 한다.


문제점

void liftOff() { /* 구현 */ }
void move(int x, int y) { /* 구현 */ }
void stop() { /* 구현 */ }
void land() { /* 구현 */ }
  • Barrack, Factory 클래스 모두에 위 코드를 작성하면 → 코드 중복 문제
  • 부모 클래스인 Building에 추가하면 → Academy, Bunker 클래스도 해당 코드를 상속받는 불필요한 상속 문제
     

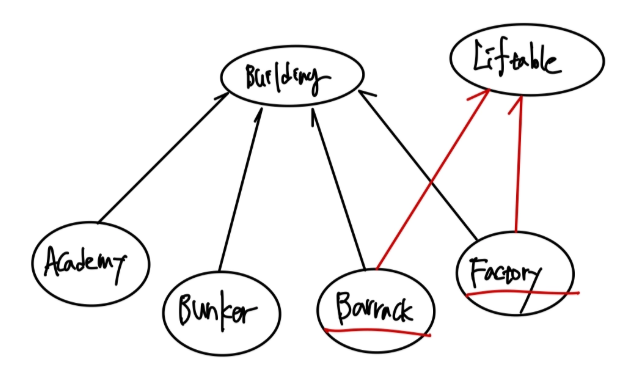
인터페이스로 해결

interface Liftable {
    void liftOff();
    void move(int x, int y);
    void stop();
    void land();
}

class LiftableImpl implements Liftable {
    public void liftOff() { /* 구현 */ }
    public void move(int x, int y) { /* 구현 */ }
    public void stop() { /* 구현 */ }
    public void land() { /* 구현 */ }
}


이후 위와 같이 Liftable 을 구현한 클래스를 각각에 적용하면된다.


코드 적용

class Barrack extends Building implements Liftable {

    LiftableImpl l = new LiftableImpl();

    public void liftOff() { l.liftOff(); }
    public void move(int x, int y) { l.move(x, y); }
    public void stop() { l.stop(); }
    public void land() { l.land(); }

    // 이하 기타 메서드...
}
// Factory도 동일하게 적용

💡 왜 바로 Barrack에 구현하지 않고 LiftableImpl을 통해 구현했을까?

  • 기능 수정이 필요할 시 LiftableImpl 수정만으로 적용된 전체 클래스 조정 가능
  • 클래스는 자신의 본래 목적(건물 생산)에만 집중하고, 부가 기능은 전담 객체에 위임
  • 바로 클래스에 구현 시 재사용성이 떨어짐


2-7. 인터페이스의 활용 (2) — 인터페이스의 본질

💡 핵심 본질

  1. 클래스를 사용하는 쪽(User)과 클래스를 제공하는 쪽(Provider)이 있다.
  2. 메서드를 호출하는 쪽(User)에서는 사용하려는 메서드(Provider)의 선언부만 알면 된다. (내용은 몰라도 된다.)


인터페이스 없이 직접 의존하는 경우

class A {
    public void methodA(B b) {
        b.methodB();
    }
}

class B {
    public void methodB() {
        System.out.println("methodB()");
    }
}

class InterfaceTest {
    public static void main(String[] args) {
        A a = new A();
        a.methodA(new B());
    }
}

// 실행 결과
// methodB()

A 클래스가 B 클래스에 직접 의존하고 있어, B가 변경되면 A도 함께 변경해야 하는 불편함이 발생한다.
이때 인터페이스를 통해 두 클래스 간의 관계를 느슨하게(간접적으로) 변경할 수 있다.


인터페이스를 통해 결합도를 낮추는 경우

class A {
    public void autoPlay(I i) {
        i.play();
    }
}

interface I {
    public abstract void play();
}

class B implements I {
    public void play() {
        System.out.println("play in B class");
    }
}

class C implements I {
    public void play() {
        System.out.println("play in C class");
    }
}

class InterfaceTest2 {
    public static void main(String[] args) {
        A a = new A();
        a.autoPlay(new B());
        a.autoPlay(new C());
    }
}

// 실행 결과
// play in B class
// play in C class

인터페이스 I를 통해 매개변수로 구현체를 동적으로 제공받을 수 있다.


제3의 클래스를 통해 제공받는 경우

class InterfaceTest3 {
    public static void main(String[] args) {
        A a = new A();
        a.methodA();
    }
}

class A {
    void methodA() {
        I i = InstanceManager.getInstance(); // 제3의 클래스 메서드 사용 (원래는 new B())
        i.methodB();
        System.out.println(i.toString());    // Object 클래스 메서드 사용
    }
}

interface I {
    public abstract void methodB();
}

class B implements I {
    public void methodB() {
        System.out.println("methodB in B class");
    }
    public String toString() { return "class B"; }
}

class InstanceManager {
    public static I getInstance() {
        return new B(); // 다른 인스턴스로 변경 시 여기만 수정하면 된다.
    }
}

// 실행 결과
// methodB in B class
// class B

getInstance() 메서드를 통해 인스턴스를 제공받으면, 나중에 다른 클래스로 변경되어도 A 클래스는 건드리지 않고 getInstance()만 수정하면 된다.


2-8. 디폴트 메서드와 static 메서드

  • static 메서드는 JDK 1.8 이후부터 인터페이스에 추가 가능


디폴트 메서드란

인터페이스에 메서드를 추가한다는 것 = 해당 인터페이스를 구현한 기존 클래스들이 새로 메서드를 추가해야 한다는 것.
이런 문제를 해결하기 위해 등장한 것이 디폴트 메서드이다.
추상 메서드의 기본적인 구현을 제공하며, 추가되어도 기존 구현체를 수정하지 않아도 된다.

interface MyInterface {
    void method();              // 추상 메서드
    default void newMethod() {} // 디폴트 메서드
}


static 메서드와 디폴트 메서드 사용 예시

class DefaultMethodTest {
    public static void main(String[] args) {
        // MyInterface inter = new Child();
        // inter.method2(); // child 가 오버라이딩 하지 않으면 MyInterface 의 method1() 도 호출 가능
        // 위 처럼 다형성을 통해 디폴트 메서드 호출 가능
        Child c = new Child();
        c.method1();
        c.method2();
        MyInterface.staticMethod();
        MyInterface2.staticMethod();
    }
}

class Child extends Parent implements MyInterface, MyInterface2 {
    public void method1() {
        MyInterface.super.method1(); // 인터페이스의 디폴트 메서드 명시적 호출
        System.out.println("method1() in Child"); // 오버라이딩
    }
}

class Parent {
    public void method2() {
        System.out.println("method2() in Parent");
    }
}

interface MyInterface {
    default void method1() {
        System.out.println("method1() in MyInterface");
    }
    default void method2() {
        System.out.println("method2() in MyInterface");
    }
    static void staticMethod() {
        System.out.println("staticMethod() in MyInterface");
    }
}

interface MyInterface2 {
    default void method1() {
        System.out.println("method1() in MyInterface2");
    }
    static void staticMethod() {
        System.out.println("staticMethod() in MyInterface2");
    }
}

// 실행 결과
// method1() in MyInterface
// method1() in Child
// method2() in Parent   ← 디폴트 메서드 충돌 시 우선순위: 클래스 >> 인터페이스
// staticMethod() in MyInterface
// staticMethod() in MyInterface2

※ Java 9부터는 인터페이스 내부에 private 메서드 구현이 가능하다. (디폴트 메서드 간 코드 공유 목적)

public interface Calculator {
    default void logStart() {
        commonLog("작업 시작");
    }

    default void logEnd() {
        commonLog("작업 종료");
    }

    // 외부에서는 호출 불가 — 인터페이스 내부에서만 사용
    private void commonLog(String message) {
        System.out.println("로그 기록: " + message);
    }
}


3. 추상 클래스 vs 인터페이스

공부 이후에 느낀 것이지만, 이 둘은 서로 비교할 대상이 아니다.

구분 추상 클래스 (abstract class) 인터페이스 (interface)
목적 상속을 통한 확장 (기능의 계층 구조) 기능 구현 강제 (다형성과 행위 정의)
핵심 키워드 "Is-a" (~이다) "Can-do" (~할 수 있다)
멤버 변수 모든 형태 가능 (상수, 일반 변수 등) public static final 상수만 가능
메서드 구현부 존재 가능 (일반/추상 혼합) default, static, private (Java 9+) 구현 가능
상속 단일 상속만 가능 다중 구현 가능
주된 용도 공통된 기능을 공유하고 계층을 구성할 때 서로 다른 클래스에서 공통된 행위를 정의할 때

참고 서적 : Java의 정석 3rd Edition (저자 : 남궁성)

개념

🚀
개념: 여러 원소들이 어떤 집합에 속해있는지 관리하는 자료구조
  - 핵심 두가지 연산

  "Find" : 특정 원소가 속한 집합의 대표자(루트)를 찾는다.
  "Union" : 두 원소가 속한 집합을 하나로 합친다.

문제 풀이를 통한 개념 익히기

문제

초기에 {0}, {1}, {2}, ... {n} 이 각각 n+1개의 집합을 이루고 있다. 여기에 합집합 연산과, 두 원소가 같은 집합에 포함되어 있는지를 확인하는 연산을 수행하려고 한다.

집합을 표현하는 프로그램을 작성하시오.

입력

첫째 줄에 n(1 ≤ n ≤ 1,000,000), m(1 ≤ m ≤ 100,000)이 주어진다. m은 입력으로 주어지는 연산의 개수이다. 다음 m개의 줄에는 각각의 연산이 주어진다. 합집합은 0 a b의 형태로 입력이 주어진다. 이는 a가 포함되어 있는 집합과, b가 포함되어 있는 집합을 합친다는 의미이다. 두 원소가 같은 집합에 포함되어 있는지를 확인하는 연산은 1 a b의 형태로 입력이 주어진다. 이는 a와 b가 같은 집합에 포함되어 있는지를 확인하는 연산이다. a와 b는 n 이하의 자연수 또는 0이며 같을 수도 있다.

출력

1로 시작하는 입력에 대해서 한 줄에 하나씩 YES/NO로 결과를 출력한다. (yes/no 를 출력해도 된다)


유니온 파인드 활용하기

🚀
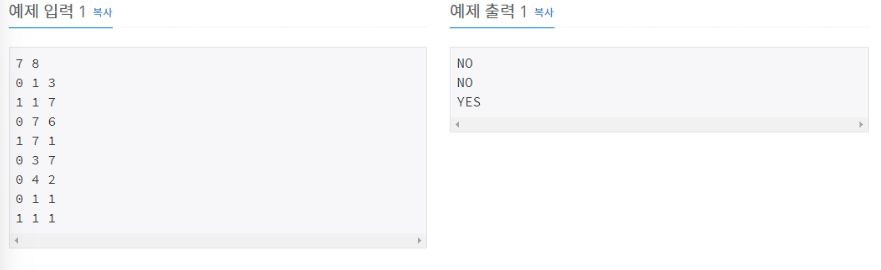
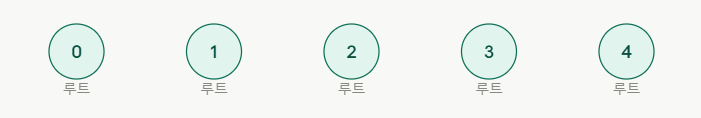
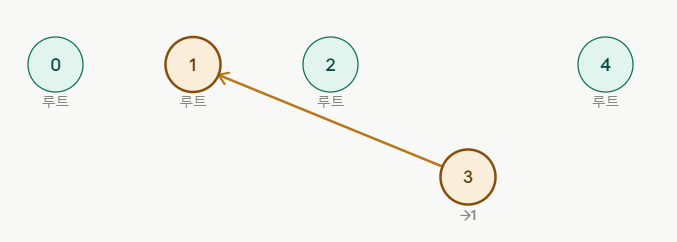
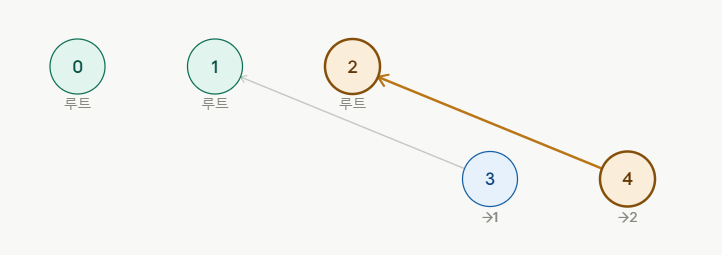
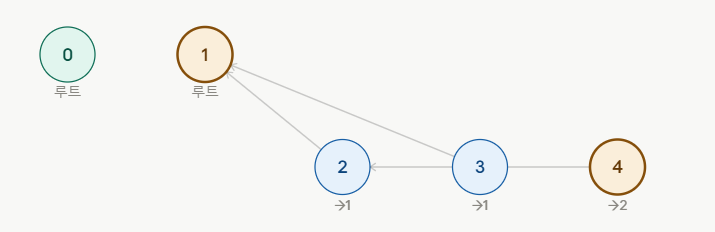
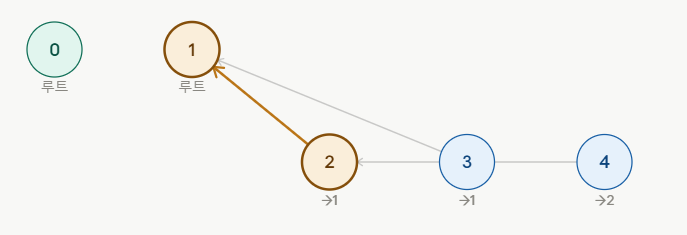
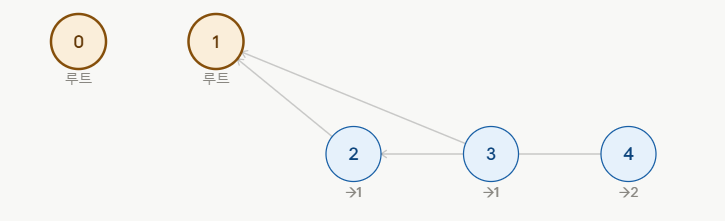
union(1,3) → union(2,4) → union(1,4) 과 isSame(1,2), isSame(1,4)
  1. 초기에는 각 원소가 자기 자신을 부모로 가진다.

  2. find(1)=1, find(3)=3 을 수행한 후 부모가 다르므로 합친다. (union(1, 3) : 3의 부모를 1로 설정)

  3. find(2)=2, find(4)=4 를 수행한 후 역시 부모가 다르므로 합친다. (union(2, 4) : 4의 부모를 2로 설정)

  4. find(1)=1, find(4)=find(2)=2 일 때 부모가 다르므로 합친다. (union(1, 4) : 2의 부모를 1로 설정)

  5. find(1)=1, find(2)=1 로 부모가 같으므로 같은 집합 (isSame(1,2) == true)

  6. find(1)=1, find(0)=0 로 부모가 다르므로 다른 집합 (isSame(1,0) == false)


문제 풀어보기 (Java)

import java.io.*;
import java.util.*;

public class BOJ1717 {

    private static int[] parent;

    private static int find(int i){
        // 부모 반환
        if(parent[i] != i){
            parent[i] = find(parent[i]); // 경로 압축
        }
        return parent[i];
    }

    private static void union(int a, int b){
        // a와 b 합집합 연산
        int ra = find(a);
        int rb = find(b);
        if(ra != rb){
            parent[rb] = ra; // 루트 끼리 연결 
            // 바로 parent[b] = a; 를 하면 루트가 아닌것 끼리 적용되어 꼬일 수 있다.
        }
    }


    public static void main(String[] args) throws IOException {

        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st = new StringTokenizer(br.readLine());

        int N = Integer.parseInt(st.nextToken()); // 입력 숫자 범위 (최대 N)
        int M = Integer.parseInt(st.nextToken()); // 연산의 개수

        parent = new int[N + 1];
        for (int i = 1; i <= N; i++) {
            parent[i] = i;
        }

        for (int i = 0; i < M; i++) {
            st = new StringTokenizer(br.readLine());
            int op = Integer.parseInt(st.nextToken());
            int a = Integer.parseInt(st.nextToken());
            int b = Integer.parseInt(st.nextToken());

            if(op == 0){
                // 합집합 연산 수행
                union(a, b);

            }
            if(op == 1){
                // 포함 여부 확인
                System.out.println(find(a) == find(b) ? "YES" : "NO");
            }


        }


    }
}


🚀
"유니온 파인드" 알고리즘은 최소 스패닝 트리를 구현하는 크루스칼 알고리즘의 기반이 된다.
  • 해당 글은 python 3.11 버전 (윈도우 11) 기준으로 작성됨
  • Anaconda 가 설치된 이후 Anaconda Prompt 를 이용하여 가상 환경을 설정함

0. 초기 Anaconda Prompt 실행 시

(base) C:\Users\taewoo>

1. 기본 패키지 채널 설정

(base) $ conda config -- add channels conda-forge
(base) $ conda config --set channel_priority strict
🚀
위 두줄 코드의 의미 : onda-forge 를 기본 패키지(1순위) 채널로 설정하고 패키지 설치 시 해당 채널에 있는 패키지들과 의존성이 완벽하게 맞는것들만 골라서 설치 한다. (버전 충돌 에러 방지)

Channel

아나콘다 패키지를 다운로드 하는 일종의 라이브러리(저장소)
기본적으로 아나콘다 공식 회사의 채널만 등록되어 있다.

conda-forge

파이썬 개발자들이 자발적으로 관리하는 거대한 커뮤니티 중심 오픈소스 채널


옵션 특징
strict 1순위 채널 무조건 맹신 및 호환성 엄격 검사
flexible 1순위 채널 우선하되, 문제 해결을 위해 하위 채널과 마구 섞어씀 (default 값)
disabled 채널 순위 상관없이 무조건 높은 버전의 패키지 사용

2. 새로운 환경 생성 및 활성화

(base) $ conda create -y -n pydata-book python=3.11
(base) $ conda env list
# conda enviornments:
#
base                  *  C:\Users\taewoo\anaconda3
py100                    C:\Users\taewoo\anaconda3\envs\py100
pydata-book              C:\Users\taewoo\anaconda3\envs\pydata-book

(base) $ conda activate pydata-book
(pydata-book) $
🚀
pydata-book 이라는 환경을 특정 파이썬 버전(3.11) 을 이용하여 생성 후 활성화 함 이다.
옵션 특징
-y 없으면 패키지 다운로드 중 Proceed([y]/n)? 를 멈추며 물어보는데 이를 모두 yes 로 바로 설치
-n name 으로서 바로 뒤의 단어를 가상환경의 이름으로 설정한다는 의미(--name 으로 풀어서 써도 됨)

3. 필수 패키지 설치

(pydata-book) $ conda install -y pandas jupyter matplotlib
🚀
패키지 설치 시 "conda install" 또는 "pip install" 을 사용하는데 우선 순위는 conda install 이다.

아나콘다는 pip 가 한 일을 모르지만 conda 로 설치하는 경우 기록이 남는다.
만약 둘을 같이 쓰면 pip 가 conda 의 기록을 무시하고 패키지를 빈곳에 집어 넣는다.
(결과적으로 패키지가 덮어씌워지거나 삭제 시 에러 발생 가능)


  • 따라서 conda 를 우선순위로 사용하고 conda 에 없는 몇몇 패키지만 pip 로 설치하는 것이 올바르다.

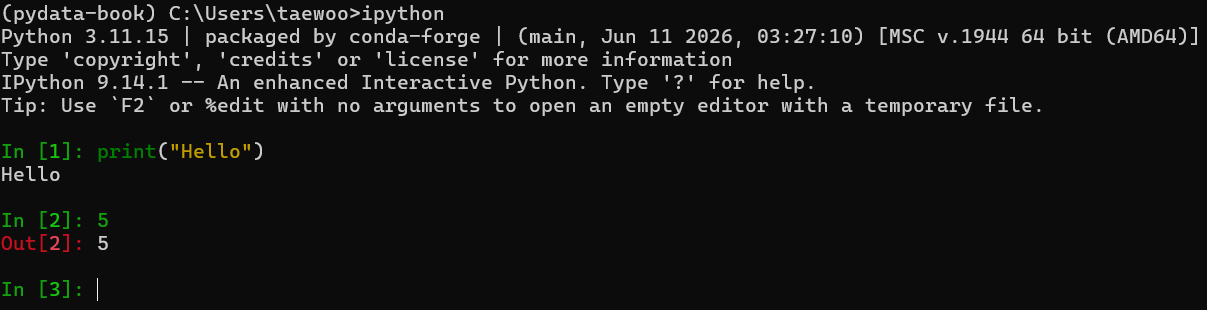
4. IPython 실행해보기

코드 실행마다 [1], [2] 처럼 번호가 나온다. "In" 은 사용자 입력, "Out" 은 시스템 출력 환경 종료 하려면 "exit()" 하면 됨

5. 주피터 노트북 실행하기

(pydata-book) $ jupyter notebook

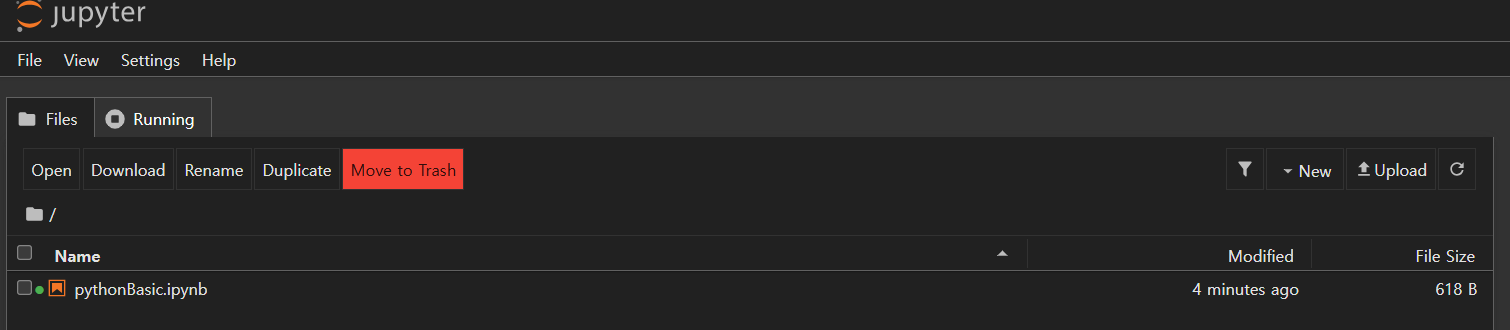
실행하면 다음과 같이 나온다. 우측 상단쪽의 'new' 를 눌러 새로운 프로젝트를 시작할 수 있다.

6. 파일 저장 디렉토리 변경

(pydata-book) C:\data-analysis>jupyter notebook
Anaconda Prompt 에서 cd 로 원하는 위치로 이동하고 환경 변경후 jupyter notebook 실행하면 된다. "환경은 global 한 위치에 저장되므로 따로 또 설치할 필요 x"
  • 변경후 깨끗한 곳에서 다시 실행해 보았다.

추가 팁

🚀
만약 github 에 올릴 시에는 코드 실행마다 협업 시에 꼬일 수 있다. Kernel -> Restart & Clear Output을 누른 뒤 저장하고 커밋해야 한다. 다른 방법으로는 jupytext 를 활용하여 '.py' 파일로 변경하여 커밋하는 방법도 있다.
  • gitignore (임시 파일 추적 제외)
.ipynb_checkpoints/
*/.ipynb_checkpoints/

+ Recent posts