이상 탐지 로직 리팩토링 & 성능 테스트
SRP 기반 메서드 분리 · 대용량 데이터 성능 측정 · VisualVM · Spring Boot
1. 개요
현재 구매 물품 리스트에 대해서 이상 탐지 로직이 수행될 때 코드가 너무 가독성이 떨어지는 것 같아 이를 리팩토링 하고자 한다.
특히 중복 탐지에 대해서는 현재 들어오는 데이터와 DB 전체의 데이터를 조회해야 하기 때문에, 만약 데이터가 많은 경우 성능 개선이 필요할 것 같아 이를 리팩토링 하고자 한다.
특히 중복 탐지에 대해서는 현재 들어오는 데이터와 DB 전체의 데이터를 조회해야 하기 때문에, 만약 데이터가 많은 경우 성능 개선이 필요할 것 같아 이를 리팩토링 하고자 한다.
이상 탐지 목록
🔍 필수 값 누락
📐 규격 불일치
📏 단위 불일치
🔁 중복
2. 현재 코드
ItemService.java
java
@Transactional
public List<Item> createCommonItem(List<CreateCommonItemDocumentReqDto> reqDtos, File savedFile) {
    DuplicateValidationResult validationResult =
        itemDocumentDuplicateValidator.markDuplicatesForCommon(reqDtos,
            itemRepository.findAllByDeletedAtIsNullOrderByIdAsc());

    return processAndSaveItemsWithDbCheck(
        reqDtos.size(),
        i -> reqDtos.get(i).getDuplicateGroupKey(),
        validationResult.existingDbMap(),
        (i, group, issueCollector, isDuplicate) -> {
            CreateCommonItemDocumentReqDto dto = reqDtos.get(i);

            ReviewStatus reviewStatus = determineReviewStatus(dto.getSpec(), dto.getUnit(), isDuplicate);

            Set<ConstraintViolation<CreateCommonItemDocumentReqDto>> violations = validator.validate(dto);
            boolean hasMissingField = !violations.isEmpty();
            boolean isDataLacking = dto.getNormalizedItemName() == null;

            if (dto.isHasParseError() || isDataLacking
                    || (reviewStatus.equals(ReviewStatus.NEW)) && hasMissingField) {
                reviewStatus = ReviewStatus.NEEDS_REVIEW;
            }

            Item item = Item.CreateCommonItem(dto, savedFile, group, reviewStatus);
            collectIssuesIfNeeded(item, dto.getSpec(), dto.getUnit(), issueCollector,
                    hasMissingField, isDataLacking);

            return item;
        }
    );
}
processAndSaveItemsWithDbCheck
java
private List<Item> processAndSaveItemsWithDbCheck(
        int size,
        Function<Integer, String> keyExtractor,
        Map<String, Item> existingDbMap,
        QuadFunction<Integer, DuplicatedGroup, Consumer<Issue>, Boolean, Item> itemMapper
) {
    Map<String, DuplicatedGroup> groupMap = new HashMap<>();
    Set<String> seenKeys = new HashSet<>();
    List<Item> itemsToSave = new ArrayList<>();
    List<Item> existingItemsToUpdate = new ArrayList<>();
    List<Issue> issues = new ArrayList<>();

    for (int i = 0; i < size; i++) {
        String duplicateKey = keyExtractor.apply(i);
        DuplicatedGroup group = null;

        if (duplicateKey != null) {
            group = groupMap.computeIfAbsent(duplicateKey, key -> {
                Item originalDbItem = existingDbMap.get(key);
                if (originalDbItem != null) {
                    if (originalDbItem.getDuplicatedGroup() != null) {
                        return originalDbItem.getDuplicatedGroup();
                    }
                    DuplicatedGroup newGroup = DuplicatedGroup.create();
                    originalDbItem.updateDuplicatedGroup(newGroup);
                    existingItemsToUpdate.add(originalDbItem);
                    return newGroup;
                }
                return DuplicatedGroup.create();
            });
        }

        boolean isDuplicate = (duplicateKey != null) &&
                (existingDbMap.containsKey(duplicateKey) || seenKeys.contains(duplicateKey));

        Item item = itemMapper.apply(i, group, issues::add, isDuplicate);
        itemsToSave.add(item);

        if (duplicateKey != null) {
            if (isDuplicate) issues.add(Issue.create(IssueType.DUPLICATE_SUSPECTED, "중복 의심", false, item));
            else seenKeys.add(duplicateKey);
        }
    }

    // ... 저장 로직 생략
    return savedItems;
}
봐도 봐도 한번에 알 수 있는 코드가 아닌 것은 확실하다. 부분 부분 살펴보면서 기능별로 분리해보고자 한다.
SRP (단일 책임 원칙) 을 최대한 준수하면서 리팩토링 해보고자 한다.
3. 메서드 별 분석
ItemService 클래스 내부의 메서드를 확인하면서 각 기능을 분석하고 책임을 분리해보고자 한다.
createCommonItem 메서드 분석
CSV, XLSX 파일이 들어오면 해당 메서드에서 이상 탐지 및 필요한 테이블에 삽입하는 역할을 한다.
-
1
DuplicateValidationResult레코드 클래스를 통해 현재 DB에 저장된 item 의 중복 탐지를 위한 key 값 데이터를 가져온다. 이 과정에서 입력 DTO 의 정규화 item 이름 값이 생성된다. -
2
입력 DTO 의 규격(spec), 단위(unit), 중복 여부(isDuplicated) 를 판단하여
ReviewStatus값을 정한다. -
3
validator 를 이용하여 필수값 누락을 확인, 그리고 ①에서 정해진 "정규화 item 이름" 이 없는지 확인하여 필수값 누락 탐지를 수행한다.
-
4
파싱 실패 시 ③의 이상현상 탐지 결과와 같은
ReviewStatus값을 부여한다. -
5
Issue 테이블 생성을 위하여
Consumer(issueCollector) 를 활용한다.
💡
Consumer 란?
Java 8 부터 제공되는
Java 8 부터 제공되는
java.util.function 패키지의 표준 함수형 인터페이스.
인자를 하나 받아서 로직을 수행하지만, 아무것도 반환하지 않는 (void) 형태이다.
java
Consumer<String> printName = name -> System.out.println("Hello, " + name);

printName.accept("Alice"); // Hello, Alice
printName.accept("Bob");   // Hello, Bob
코드를 분석하면서도 위아래로 왔다갔다 하며 이해하는 데 시간이 오래 걸렸다. 지금부터는 기능별로 정리 후 가독성 높은 코드로 수정해보겠다.
4. 필요 기능 리스트 업
파일 업로드에 대한 필요 기능을 리스트 업 한다. 최대한 작은 단위로 기능을 정리할 것이다.
- 1아이템 이름 → 정규화 이름 매핑
- 2입력된 파일의 row 들과 기존 DB 의 row 들을 비교 (키 만들기)
- 3중복 탐지
- 4기타 이상 탐지 (필수 값 누락, 규격 및 단위 불일치)
- 5이상탐지에 대한 Issue 생성 및 DB 저장 (이슈는 여러 개 생성 가능)
- 6Item 생성 및 DB 저장 (⑤와 함께 수행되어야 함)
5. 본격 리팩토링
최대한 서비스 메서드 내부에 간결한 메서드 호출로 작성하려고 노력하였다.
ItemService.java — 리팩토링 후 서비스 메서드
java
@Transactional
public List<Item> createCommonItem(List<CreateCommonItemDocumentReqDto> reqDtos, File savedFile) {

    // 1. 검증 및 중복 매핑 결과 취득
    DuplicateValidationResult validationResult =
        itemDocumentDuplicateValidator.markDuplicatesForCommon(
            reqDtos, itemRepository.findAllByDeletedAtIsNullOrderByIdAsc()
        );

    List<Item> existingItemsToUpdate = new ArrayList<>();
    List<Boolean> isDuplicateFlags = new ArrayList<>();

    // 2. DTO -> Item 엔티티 및 DuplicatedGroup 연관관계 구성
    List<Item> itemsToSave = processItemsAndGroups(
        reqDtos, validationResult, savedFile, existingItemsToUpdate, isDuplicateFlags
    );

    // 3. 기타 이상 탐지 및 이슈(Issue) 수집
    List<Issue> issues = detectIssues(itemsToSave, reqDtos, isDuplicateFlags);

    // 4. 데이터 일괄 저장 (Item, Issue, Group 등)
    return saveAllEntities(itemsToSave, existingItemsToUpdate, issues);
}
📦 processItemsAndGroups
DTO → Item 변환 + 그룹 연관 관계 구성
java
private List<Item> processItemsAndGroups(
        List<CreateCommonItemDocumentReqDto> reqDtos,
        DuplicateValidationResult validationResult,
        File savedFile,
        List<Item> existingItemsToUpdate,
        List<Boolean> isDuplicateFlags
) {
    Map<String, DuplicatedGroup> groupMap = new HashMap<>();
    List<Item> items = new ArrayList<>();
    Set<String> seenKeys = new HashSet<>();

    for (CreateCommonItemDocumentReqDto dto : reqDtos) {
        String groupKey = dto.getDuplicateGroupKey();
        DuplicatedGroup group = resolveDuplicatedGroup(
            groupKey, groupMap, validationResult.existingDbMap(), existingItemsToUpdate
        );

        boolean isDuplicated = (groupKey != null) &&
                (validationResult.existingDbMap().containsKey(groupKey) || seenKeys.contains(groupKey));

        if (groupKey != null) seenKeys.add(groupKey);
        isDuplicateFlags.add(isDuplicated);

        Set<ConstraintViolation<CreateCommonItemDocumentReqDto>> violations = validator.validate(dto);
        boolean hasMissingFieldOrDataLacking =
            !violations.isEmpty() || (dto.getNormalizedItemName() == null);

        ReviewStatus reviewStatus = determineReviewStatusV2(
            dto.getSpec(), dto.getUnit(), isDuplicated, hasMissingFieldOrDataLacking
        );

        items.add(Item.CreateCommonItem(dto, savedFile, group, reviewStatus));
    }
    return items;
}
🔍 resolveDuplicatedGroup
중복 그룹 결정 (3가지 케이스)
java
private DuplicatedGroup resolveDuplicatedGroup(
        String groupKey,
        Map<String, DuplicatedGroup> groupMap,
        Map<String, Item> existingDbMap,
        List<Item> existingItemsToUpdate
) {
    if (groupKey == null) return null;

    return groupMap.computeIfAbsent(groupKey, key -> {
        Item originalDbItem = existingDbMap.get(key);

        if (originalDbItem != null) {
            // Case 1: 기존 DB 항목에 이미 중복 그룹이 존재
            if (originalDbItem.getDuplicatedGroup() != null)
                return originalDbItem.getDuplicatedGroup();

            // Case 2: DB 항목은 있지만 중복 그룹 없음 → 새 그룹 생성 후 업데이트
            DuplicatedGroup newGroup = DuplicatedGroup.create();
            originalDbItem.updateDuplicatedGroup(newGroup);
            existingItemsToUpdate.add(originalDbItem);
            return newGroup;
        }

        // Case 3: DB 항목 없이 요청 DTO 간 내부 중복
        return DuplicatedGroup.create();
    });
}
⚠️ detectIssues
4가지 이상 탐지 → Issue 수집
java
private List<Issue> detectIssues(
        List<Item> itemsToSave,
        List<CreateCommonItemDocumentReqDto> reqDtos,
        List<Boolean> isDuplicateFlags
) {
    List<Issue> issues = new ArrayList<>();

    for (int i = 0; i < itemsToSave.size(); i++) {
        Item item = itemsToSave.get(i);
        CreateCommonItemDocumentReqDto dto = reqDtos.get(i);
        boolean isDuplicated = isDuplicateFlags.get(i);

        // 1. 규격(Spec) 불일치
        if (itemSpecAndUnitValidator.isSpecMismatch(dto.getSpec()))
            issues.add(Issue.create(IssueType.SPEC_MISMATCH, "규격 불일치", false, item));

        // 2. 단위(Unit) 불일치
        if (itemSpecAndUnitValidator.isUnitMismatch(dto.getUnit()))
            issues.add(Issue.create(IssueType.UNIT_MISMATCH, "단위 불일치", false, item));

        // 3. 필수값 누락
        boolean hasMissingField = !validator.validate(dto).isEmpty();
        boolean isDataLacking = (dto.getNormalizedItemName() == null);
        if (isDataLacking || hasMissingField)
            issues.add(Issue.create(IssueType.MISSING_REQUIRED, "필수값 누락", false, item));

        // 4. 중복 의심 (후속 중복 항목일 때만)
        if (isDuplicated)
            issues.add(Issue.create(IssueType.DUPLICATE_SUSPECTED, "중복 의심", false, item));
    }
    return issues;
}
💾 saveAllEntities
순서 보장 일괄 저장
java
private List<Item> saveAllEntities(
        List<Item> itemsToSave,
        List<Item> existingItemsToUpdate,
        List<Issue> issues
) {
    // 1. 아직 저장되지 않은(id == null) DuplicatedGroup 우선 저장
    List<DuplicatedGroup> newGroupsToSave = itemsToSave.stream()
        .map(Item::getDuplicatedGroup)
        .filter(g -> g != null && g.getId() == null)
        .distinct().toList();

    if (!newGroupsToSave.isEmpty())
        duplicatedGroupRepository.saveAll(newGroupsToSave);

    // 2. 새 그룹이 할당된 기존 DB Item 업데이트
    if (!existingItemsToUpdate.isEmpty())
        itemRepository.saveAll(existingItemsToUpdate);

    // 3. 신규 Item 저장
    List<Item> savedItems = itemRepository.saveAll(itemsToSave);

    // 4. Issue 저장
    if (!issues.isEmpty())
        issueRepository.saveAll(issues);

    return savedItems;
}
🏷️ determineReviewStatusV2
ReviewStatus 우선순위 결정
java
private ReviewStatus determineReviewStatusV2(
        String spec, String unit,
        boolean isDuplicated,
        boolean hasMissingFieldOrDataLacking
) {
    // 1순위. 필수값 누락 → NEEDS_REVIEW
    if (hasMissingFieldOrDataLacking) return ReviewStatus.NEEDS_REVIEW;

    // 2순위. 규격/단위 불일치 또는 중복 → ON_HOLD
    boolean hasSpecOrUnitIssue =
        itemSpecAndUnitValidator.isSpecMismatch(spec) || itemSpecAndUnitValidator.isUnitMismatch(unit);

    if (hasSpecOrUnitIssue || isDuplicated) return ReviewStatus.ON_HOLD;

    // 3순위. 이상 없음 → NEW
    return ReviewStatus.NEW;
}
✅
Function 사용을 지양하고 일반 메서드 사용을 추구함으로써 가독성을 높이고자 노력하였다.
아직 코드적으로 개선 사항이 많지만, 아래 6번 성능 이슈로 인해 코드가 완전히 변경될 수 있어 이 정도 리팩토링으로 일단 마무리하고자 한다.
아직 코드적으로 개선 사항이 많지만, 아래 6번 성능 이슈로 인해 코드가 완전히 변경될 수 있어 이 정도 리팩토링으로 일단 마무리하고자 한다.
6. 성능 테스트 및 개선 사항
🚨
기능 체크 사항
대용량 파일 입력 (10만 row 이상) + 이상 탐지 프로세스
응답 시간 성능 개선 및 중복 탐지 시 JVM 메모리 오버 가능성이 있으므로 이를 해결해야 한다. (현재 Map 상에 모든 중복 Key 값이 들어가기 때문)
대용량 파일 입력 (10만 row 이상) + 이상 탐지 프로세스
응답 시간 성능 개선 및 중복 탐지 시 JVM 메모리 오버 가능성이 있으므로 이를 해결해야 한다. (현재 Map 상에 모든 중복 Key 값이 들어가기 때문)
6-1. 응답 시간 측정
| 데이터 규모 | 소요 시간 | 비고 |
|---|---|---|
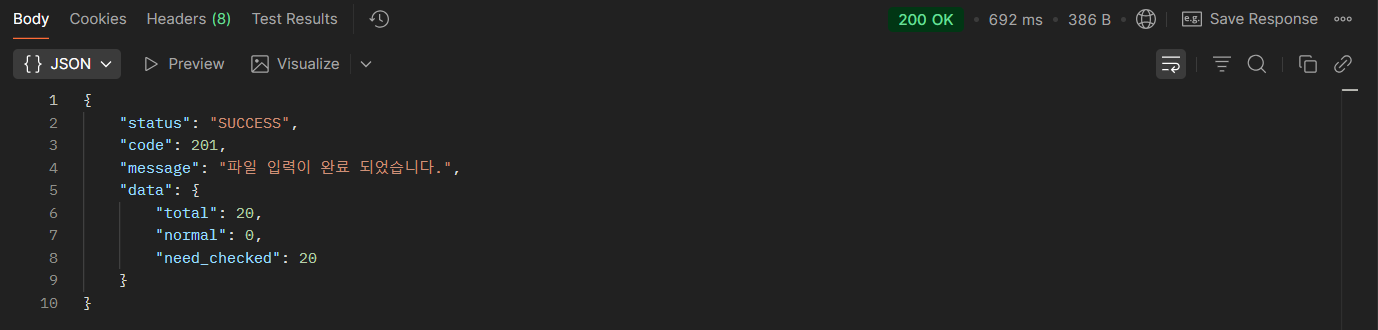
| 20 row (CSV) | 692 ms | 파싱 + 중복 판단 포함 |
| 1,000 row (1차) | 약 8 s | 신규 입력 |
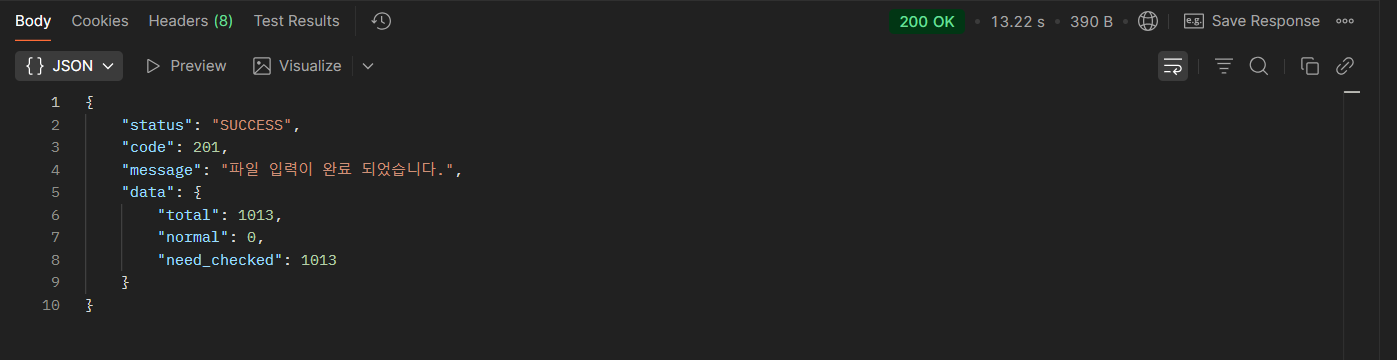
| 1,000 row (2차) | 13.22 s | 기존 1,000건과 중복 비교 발생 → 느려짐 |
| 1,000 row (3차) | 약 8 s | 2차 입력분이 update 안 되어 그 시간만큼 단축 |
| 10만 row | 단순 계산 약 1시간 예상 | 메모리 오버 + 비효율 발생 확인 |
20 row 입력 결과
1,000 row 입력 — application.yml 추가 설정 필요
application.yml
yaml
servlet:
  multipart:
    max-file-size: 10MB
    max-request-size: 10MB
⇒ 10만 개의 경우 단순 계산으로 약 1시간 정도 소요 되기에 일단은 1000개의 row 로 테스트 해보았다.
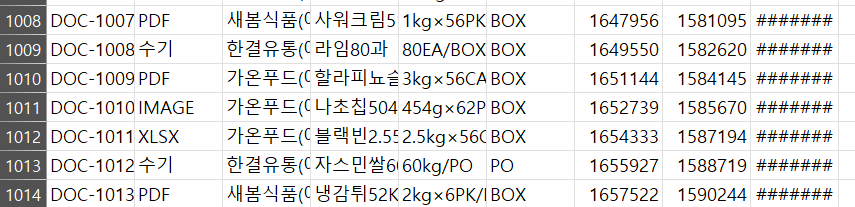
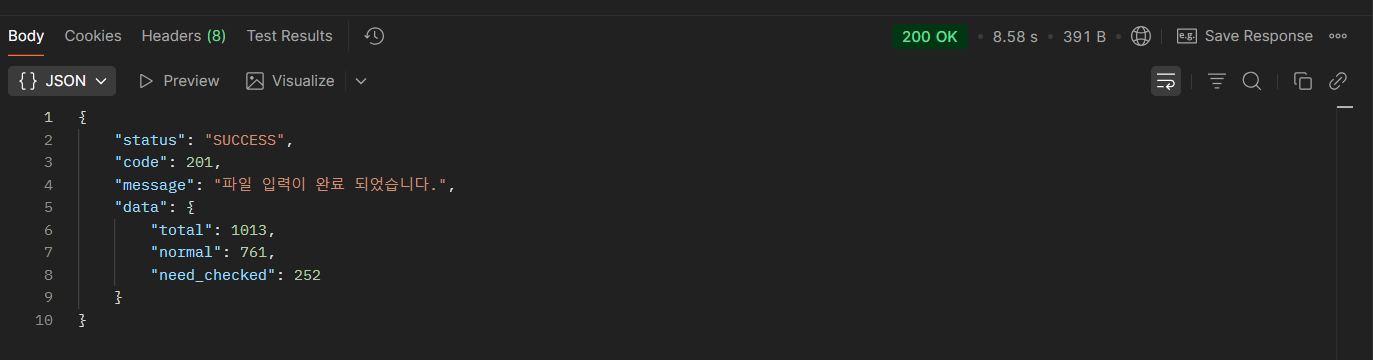
⇒ 1000개의 row 정도는 약 8초 정도 걸렸다.
⇒ 이 이후에 1000개 정도의 데이터를 다시 입력하면 처음 입력보다 더 오래걸린다. (13.22s)
⇒ 이 이후 동일 데이터를 넣어보면 처음과 비슷하게 8초 정도가 소요되는데 이는 처음 입력 데이터 1000개가 update 되지 않기 때문에 그 시간 만큼 덜 소요된 것이다.
하지만 문제는 이 이후이다. 이 1000개의 데이터를 만약 중복 탐지를 위해 메로리 상에 모두 올리게 된다면?
6-2. 메모리 측정 (VisualVM)
* VisualVM 사용법 참고 사이트
📖 Java 성능 모니터링 — VisualVM 분석 및 연동평소 상태
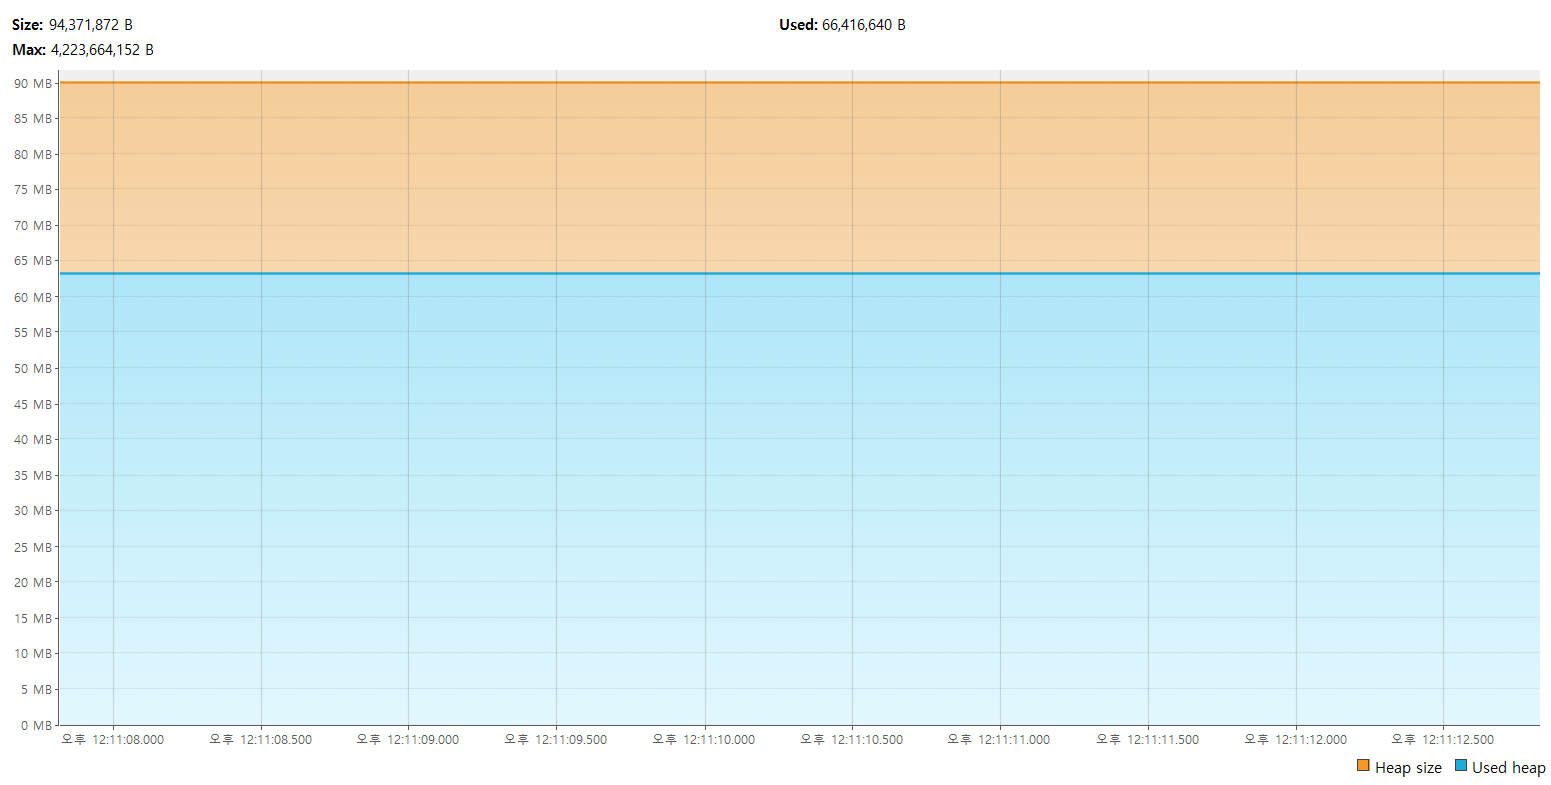
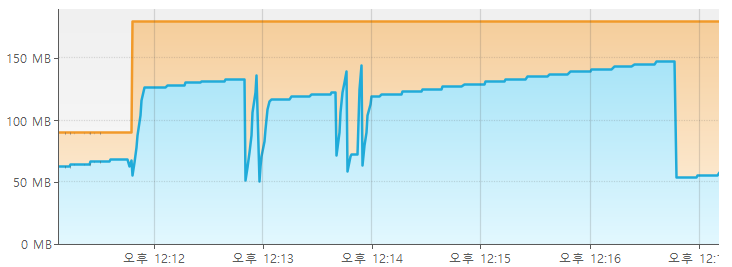
1,000 row 입력 시
📊
주황 부분이 할당된 Heap 사이즈, 파란 부분이 사용된 Heap 사이즈이다.
보통 50~70% 사이가 안정적인 구간이라고 하는데, 현재 1,000개 정도의 적은 데이터임에도 최대 75% 에 육박하는 그래프를 보인다.
DB 의 데이터가 증가될수록 사용량이 많아질 것이다.
보통 50~70% 사이가 안정적인 구간이라고 하는데, 현재 1,000개 정도의 적은 데이터임에도 최대 75% 에 육박하는 그래프를 보인다.
DB 의 데이터가 증가될수록 사용량이 많아질 것이다.
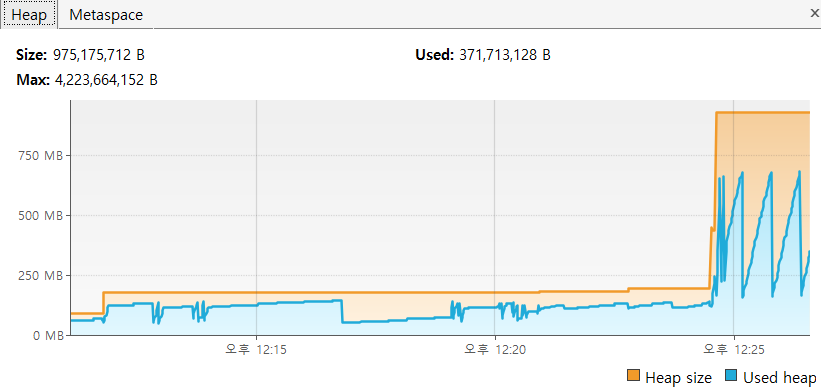
10만 row 입력 시
⚠️
서버의 메모리 자원을 늘리면서 비효율적으로 작업이 진행되는 것을 확인할 수 있다.
🚀
따라서 다음 포스트에서는 위 성능 테스트를 바탕으로 개선을 진행하고자 한다.
이 도전이 DB 관리에 있어서 의미 있는 도전이 되기를 바란다.
이 도전이 DB 관리에 있어서 의미 있는 도전이 되기를 바란다.
'프로젝트 > 보살핌 프로젝트' 카테고리의 다른 글
| 3. 중복 탐지 로직 최적화 (1) (0) | 2026.09.03 |
|---|---|
| 2. 입력 최적화 (0) | 2026.08.31 |
| 0. 해커톤 개요 (0) | 2026.08.25 |